Softwarentwicklung

Agile Softwareentwicklung
Klassische Softwareentwicklungsmethoden wie das Wasserfallmodell setzen darauf, zu Anfang eines Projekts genau die Anforderungen etwa in einem Pflichtenheft festzuhalten, nach denen die Software entwickelt wird. Dies ist eine nicht ganz unerhebliche Aufgabe, da sich genaue Anforderungen für den Einsatz am Markt mitunter zu Projektstart noch nicht bis ins letzte Detail definieren lassen.Agile Softwareentwicklung hingegen setzt darauf, so früh wie möglich ein laufendes System auszuliefern. das dann in Iterationen und basierend auf dem Feedback des Nutzers immer weiter entwickelt wird.
Manifest für Agile Softwareentwicklung
Was verstehen wir untern diesem Begriff?
- Persönliche Betreuung, kleines und flexibles Team!
- Agile Prozesse benötigten weniger Zeit und Planungsspannen
- Dadurch können Unternehmen letztlich Kosten einsparen
- Schnelle und flexibel Reaktion auf Veränderungen
- Unser Unternehmen ist uns wichtig, es ist unser Unternehmen!

iSeries M3 Prozess-Überwachung
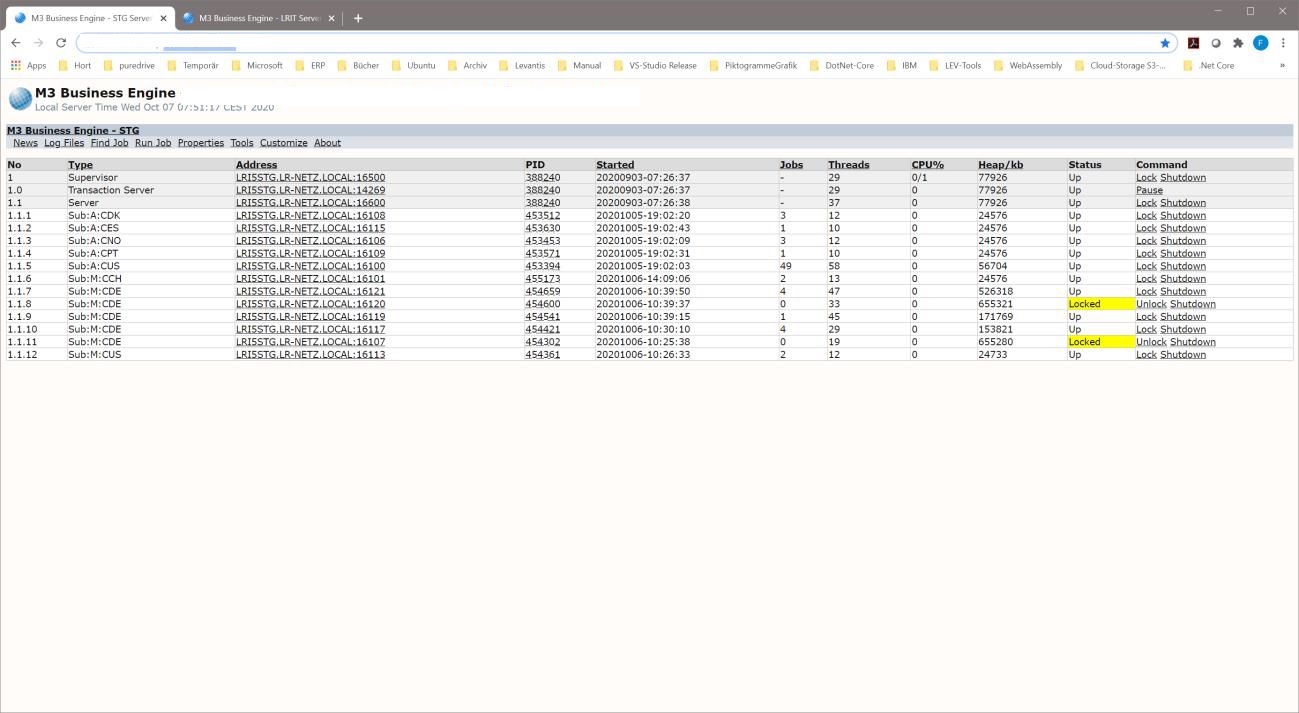
Auf der in der Abbildung gezeigten Seite müssen die einzelnen Subsysteme verwaltet, geprüft und überwacht werden. Liest man die genaueren Anforderungen welche dem Projekt zu Grunde lagen, muss man feststellen, dass dafür täglich einiges an Zeit aufgewendet werden muss. Zudem gibt es Aktivitäten, welche erst am Abend ausgeführt werden können.
Ziel war es, diese beschriebenen Aufgaben soweit wie möglich zu automatisieren.
Nach einer Analyse der Prozess-Seite, konnten wir feststellen, dass alle Operationen als http-Request ausgeführt wurden. Daher wurde beschlossen, das Ganze als REST-API zur realisieren. Auf Grund der diversen verschiedenen Anforderungen wurden für die einzelnen Aufgabenbereiche eigene Services realisiert.
- Task Cleanup: Subsysteme beenden und auf Neustart warten
- Task Daily: Überwachung des Heap-Speicher und Lock Subsystem
- Taks Sub A: Überwachung und SMS / Neustart der Subsysteme
- Task Shutdown: Beenden Subsysteme mit Status => Locked
Zur Ausführung der einzelnen Operationen (Command) wurde eine REST-API Schnittstelle mit http-Request/-Response implementiert.
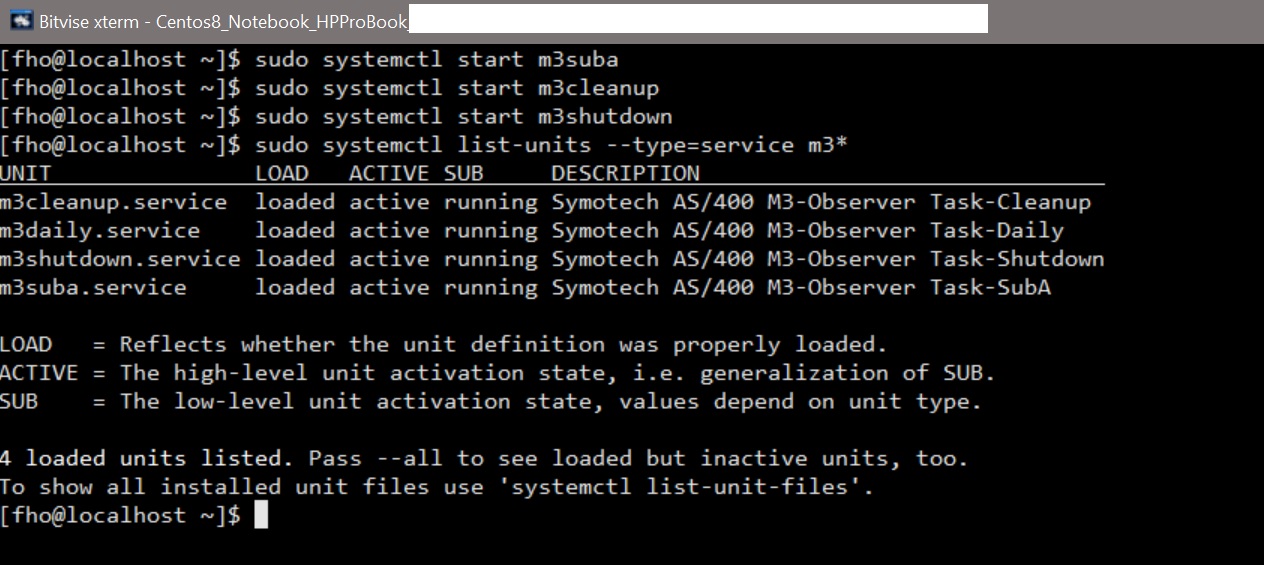
Die vier beschriebenen Services wurden implementiert, und auf dem CentOS-Linux als Service eingerichtet. Diese werden mit der aktuellen Konfiguration auch nach einem Neustart des Rechners wieder aktiviert.
Microsoft Graph & CSP Authentifizierung mit Microsoft-SDK
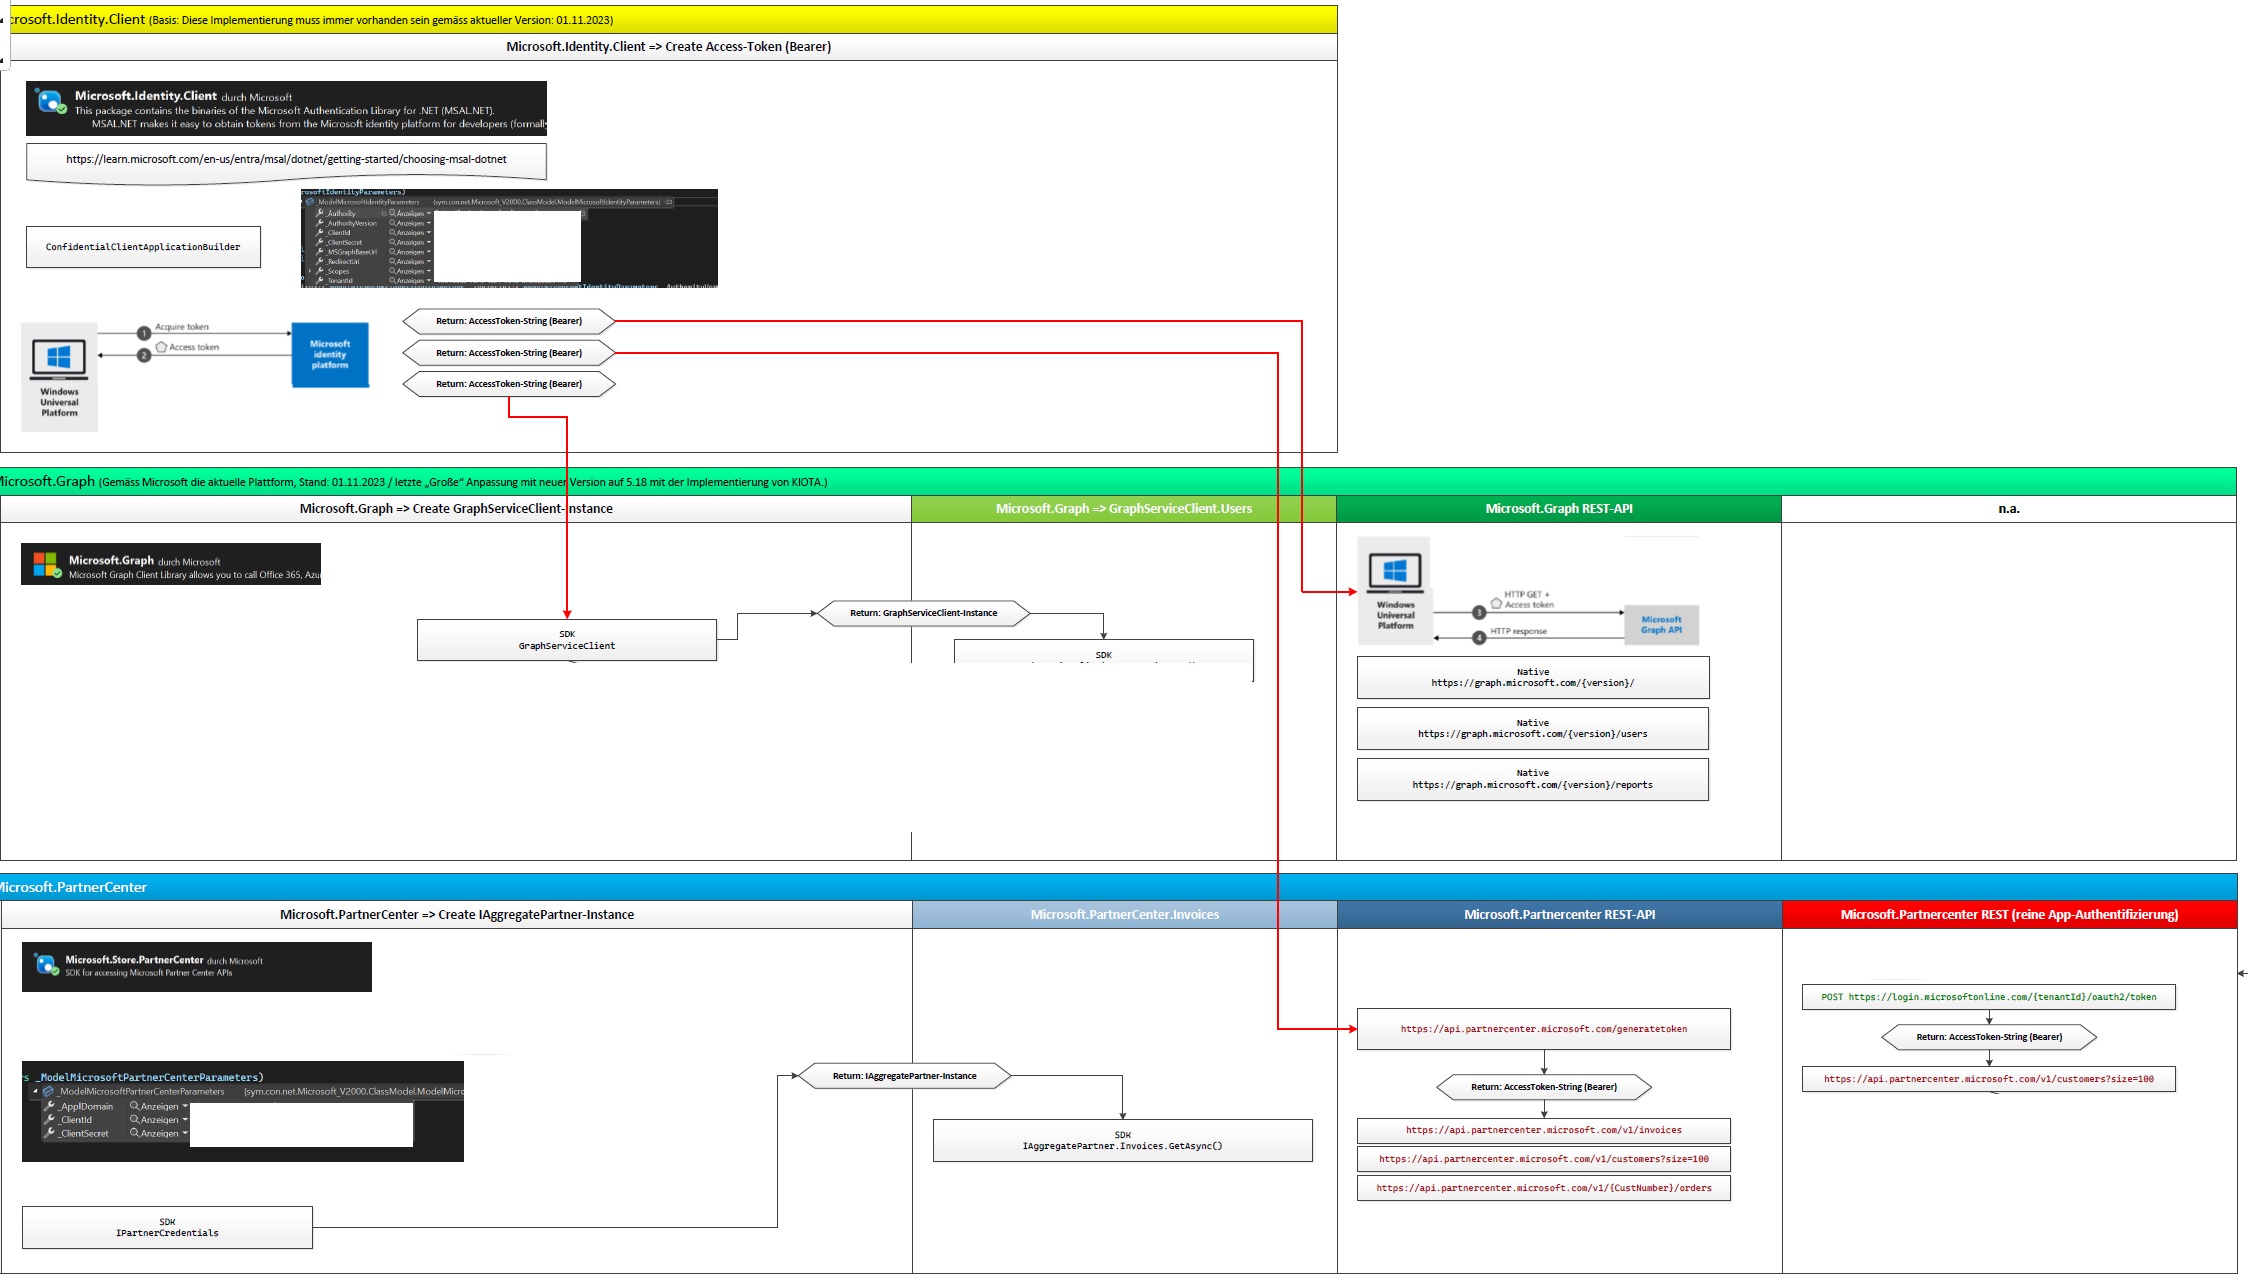
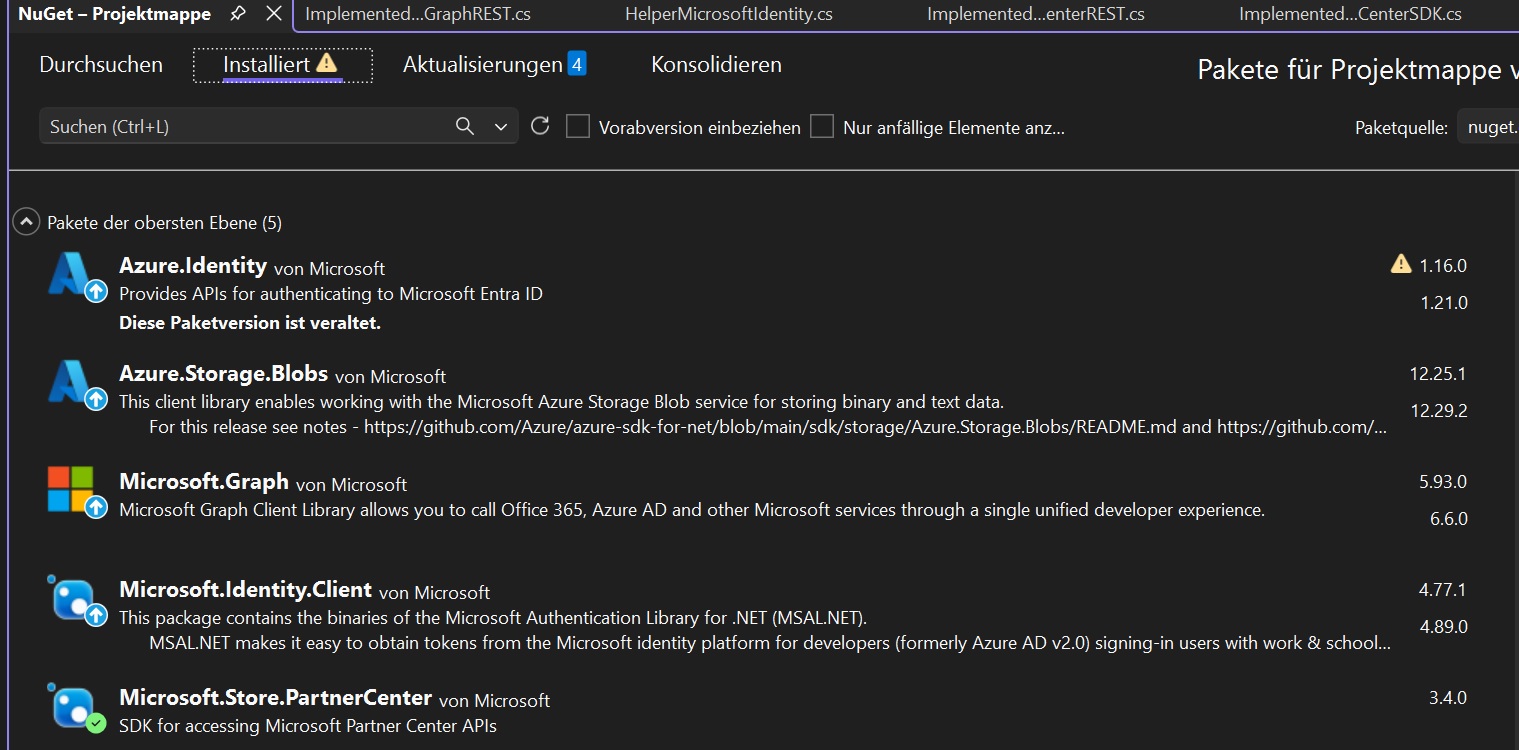
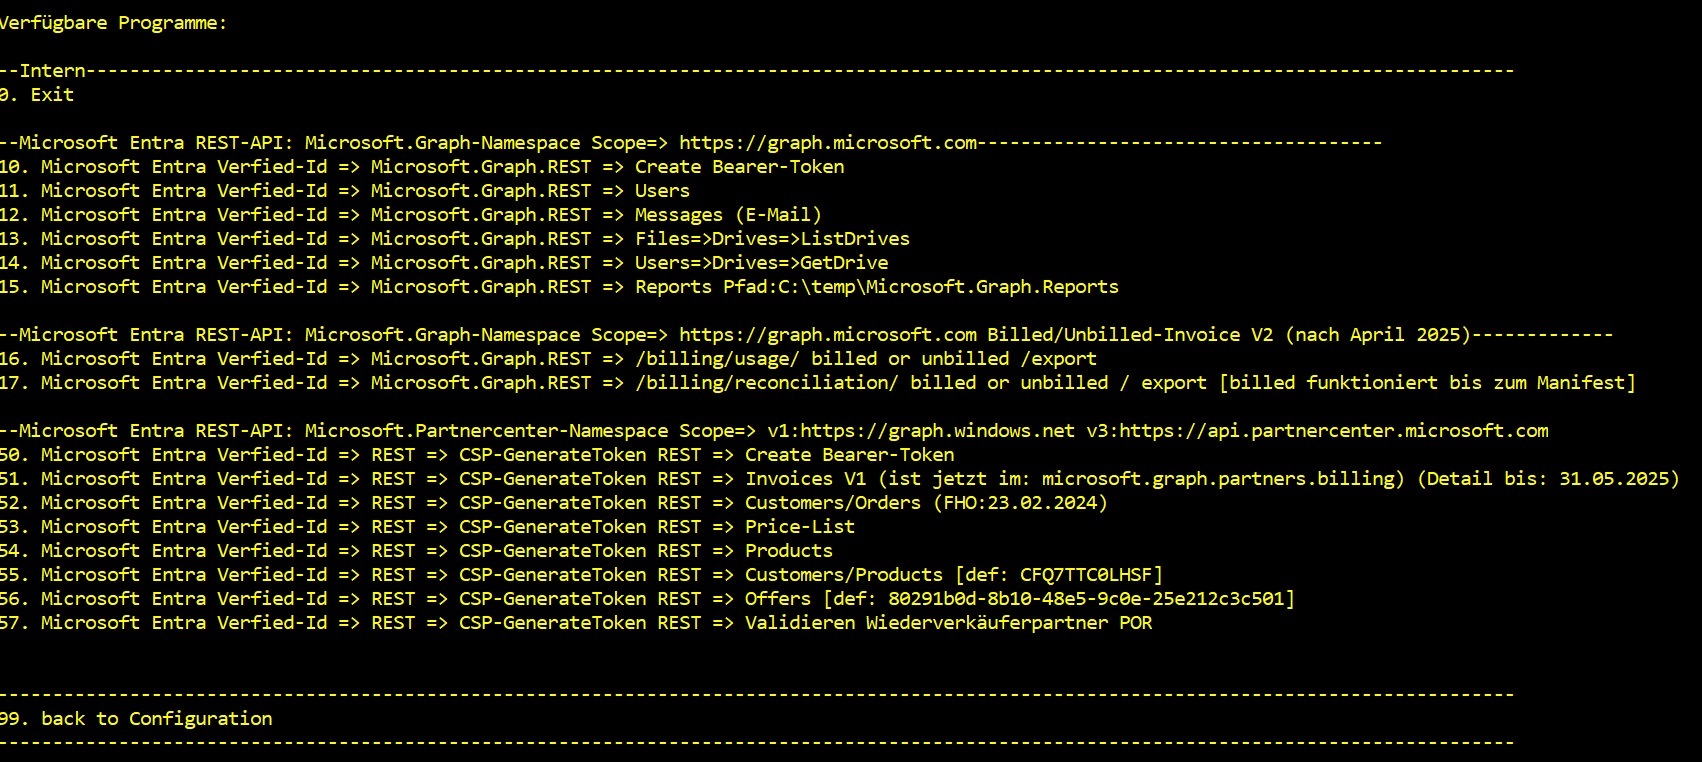
Das Microsoft Partner Center SDK ermöglicht CSP-Partnern, ihre eigenen CRM-, ERP- oder Abrechnungssysteme mit Microsoft Partner Center zu integrieren.
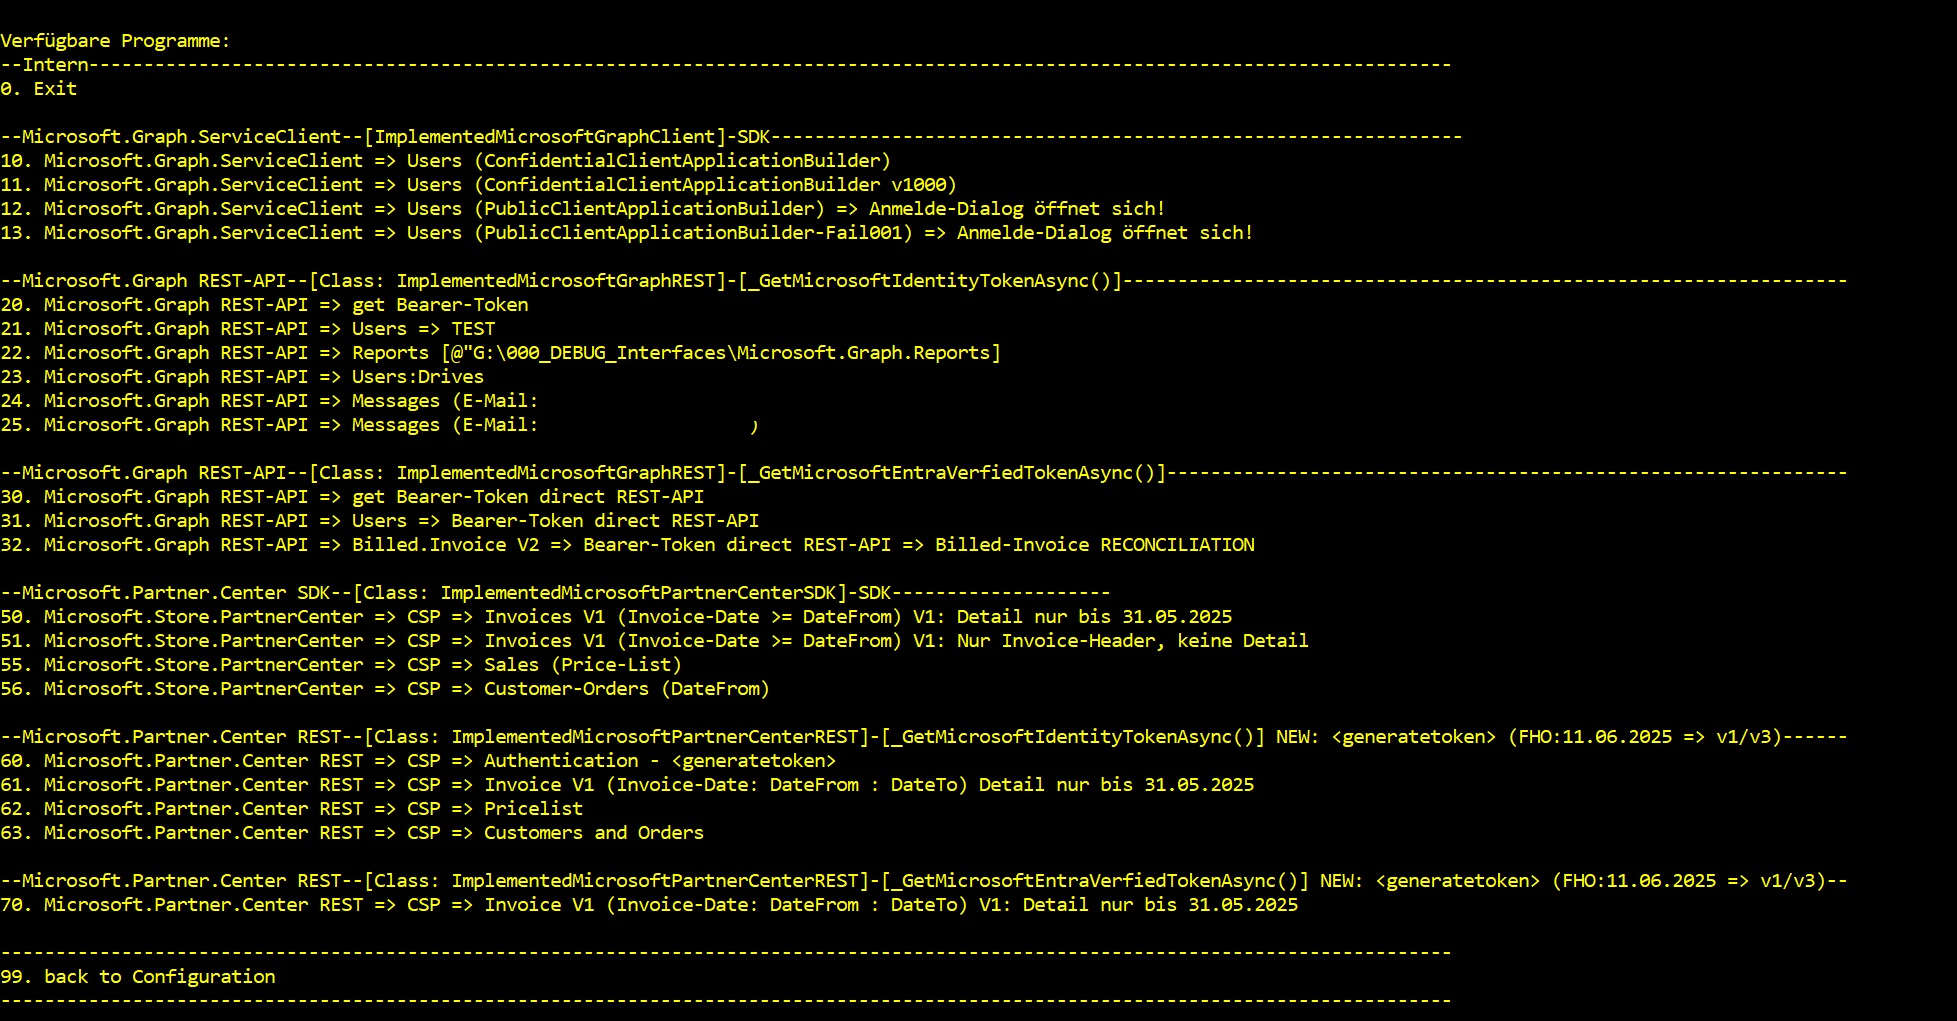
Damit lassen sich z. B. Kunden, Abonnements, Bestellungen und Abrechnung automatisieren, siehe Console unten:
Aktueller Stand
- REST API: von Microsoft aktuell der bevorzugte Weg.
- .NET SDK: seit Version 3.4.0 archiviert; Microsoft empfiehlt für neue Entwicklungen die REST APIs.
Problem
Wir mussten unsere Programme und die entsprechenden Authentifizierungs-Varianten permanent an die neue Gegebenheiten von Microsoft anpassen. Das war einfach mittlerweile ein permanenter Prozess, welcher pro aktiv auf Basis der von Microsoft veröffentlichten Mitteilungen durchgeführt werden musste!Entra Verfied-Id: Microsoft Graph & CSP Authentifizierung ohne Microsoft-SDK
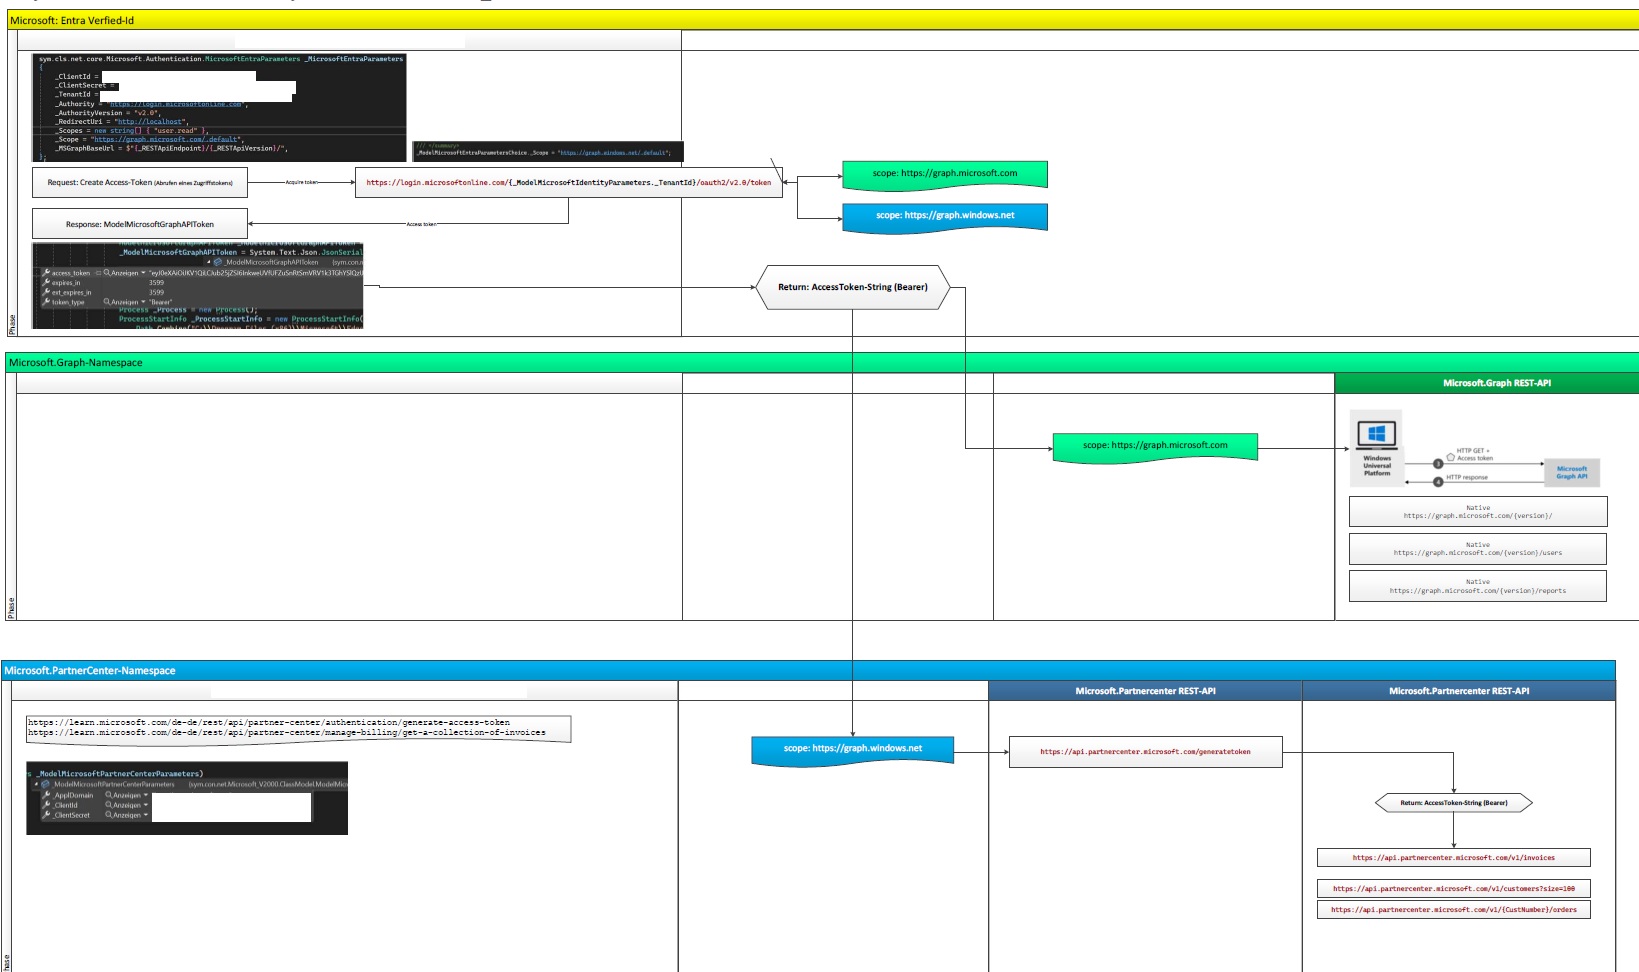
Microsoft Entra Verified ID ist Microsofts Lösung für verifizierbare digitale Nachweise (Verifiable Credentials). Sie basiert auf dezentralen Identitäten und ermöglicht es, digitale Nachweise kryptografisch zu erstellen, zu speichern und zu überprüfen.
Microsoft beschreibt Verified ID als Dienst für Verifiable Credentials, bei dem Organisationen Credentials ausstellen und andere Anwendungen diese kryptografisch verifizieren können. Für Issuance und Verification steht eine REST-API zur Verfügung.
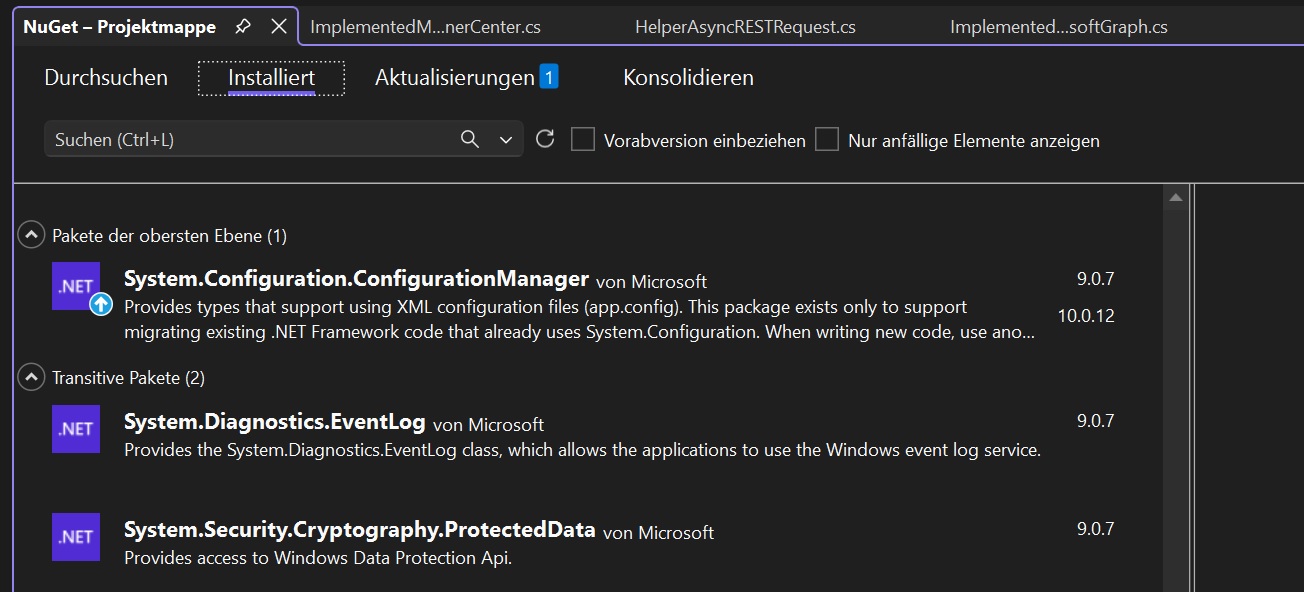
Der absolute Vorteil dieser Variante ist, es braucht keine, absolut keine speziellen SDK's die installiert und permanent gewartet werden müssen!
Digitales Dokumenten-Archiv (Basis: Revisionssicher)
- Web-Client auf Basis PHP (Windows IIS / Linux Apache, Nginx, Kestrell
- Durch den Kunden einstellbare Ansichten / Abfragen etc.
- Revisionskonform und Hochverfügbar
- Kunden-Schnittstellen für permanenten Datenupload
- Mehrschichtiger Upload-Client mit STS (Security-Token) Authentifizierung
Automatischer Upload-Client für Einzel-/Sammel-Dokumente
Lokaler Windows-Dienst der alle Daten (Dokumente/Meta-Daten) aus einem Verzeichnis an das Digital-Archiv sendet.
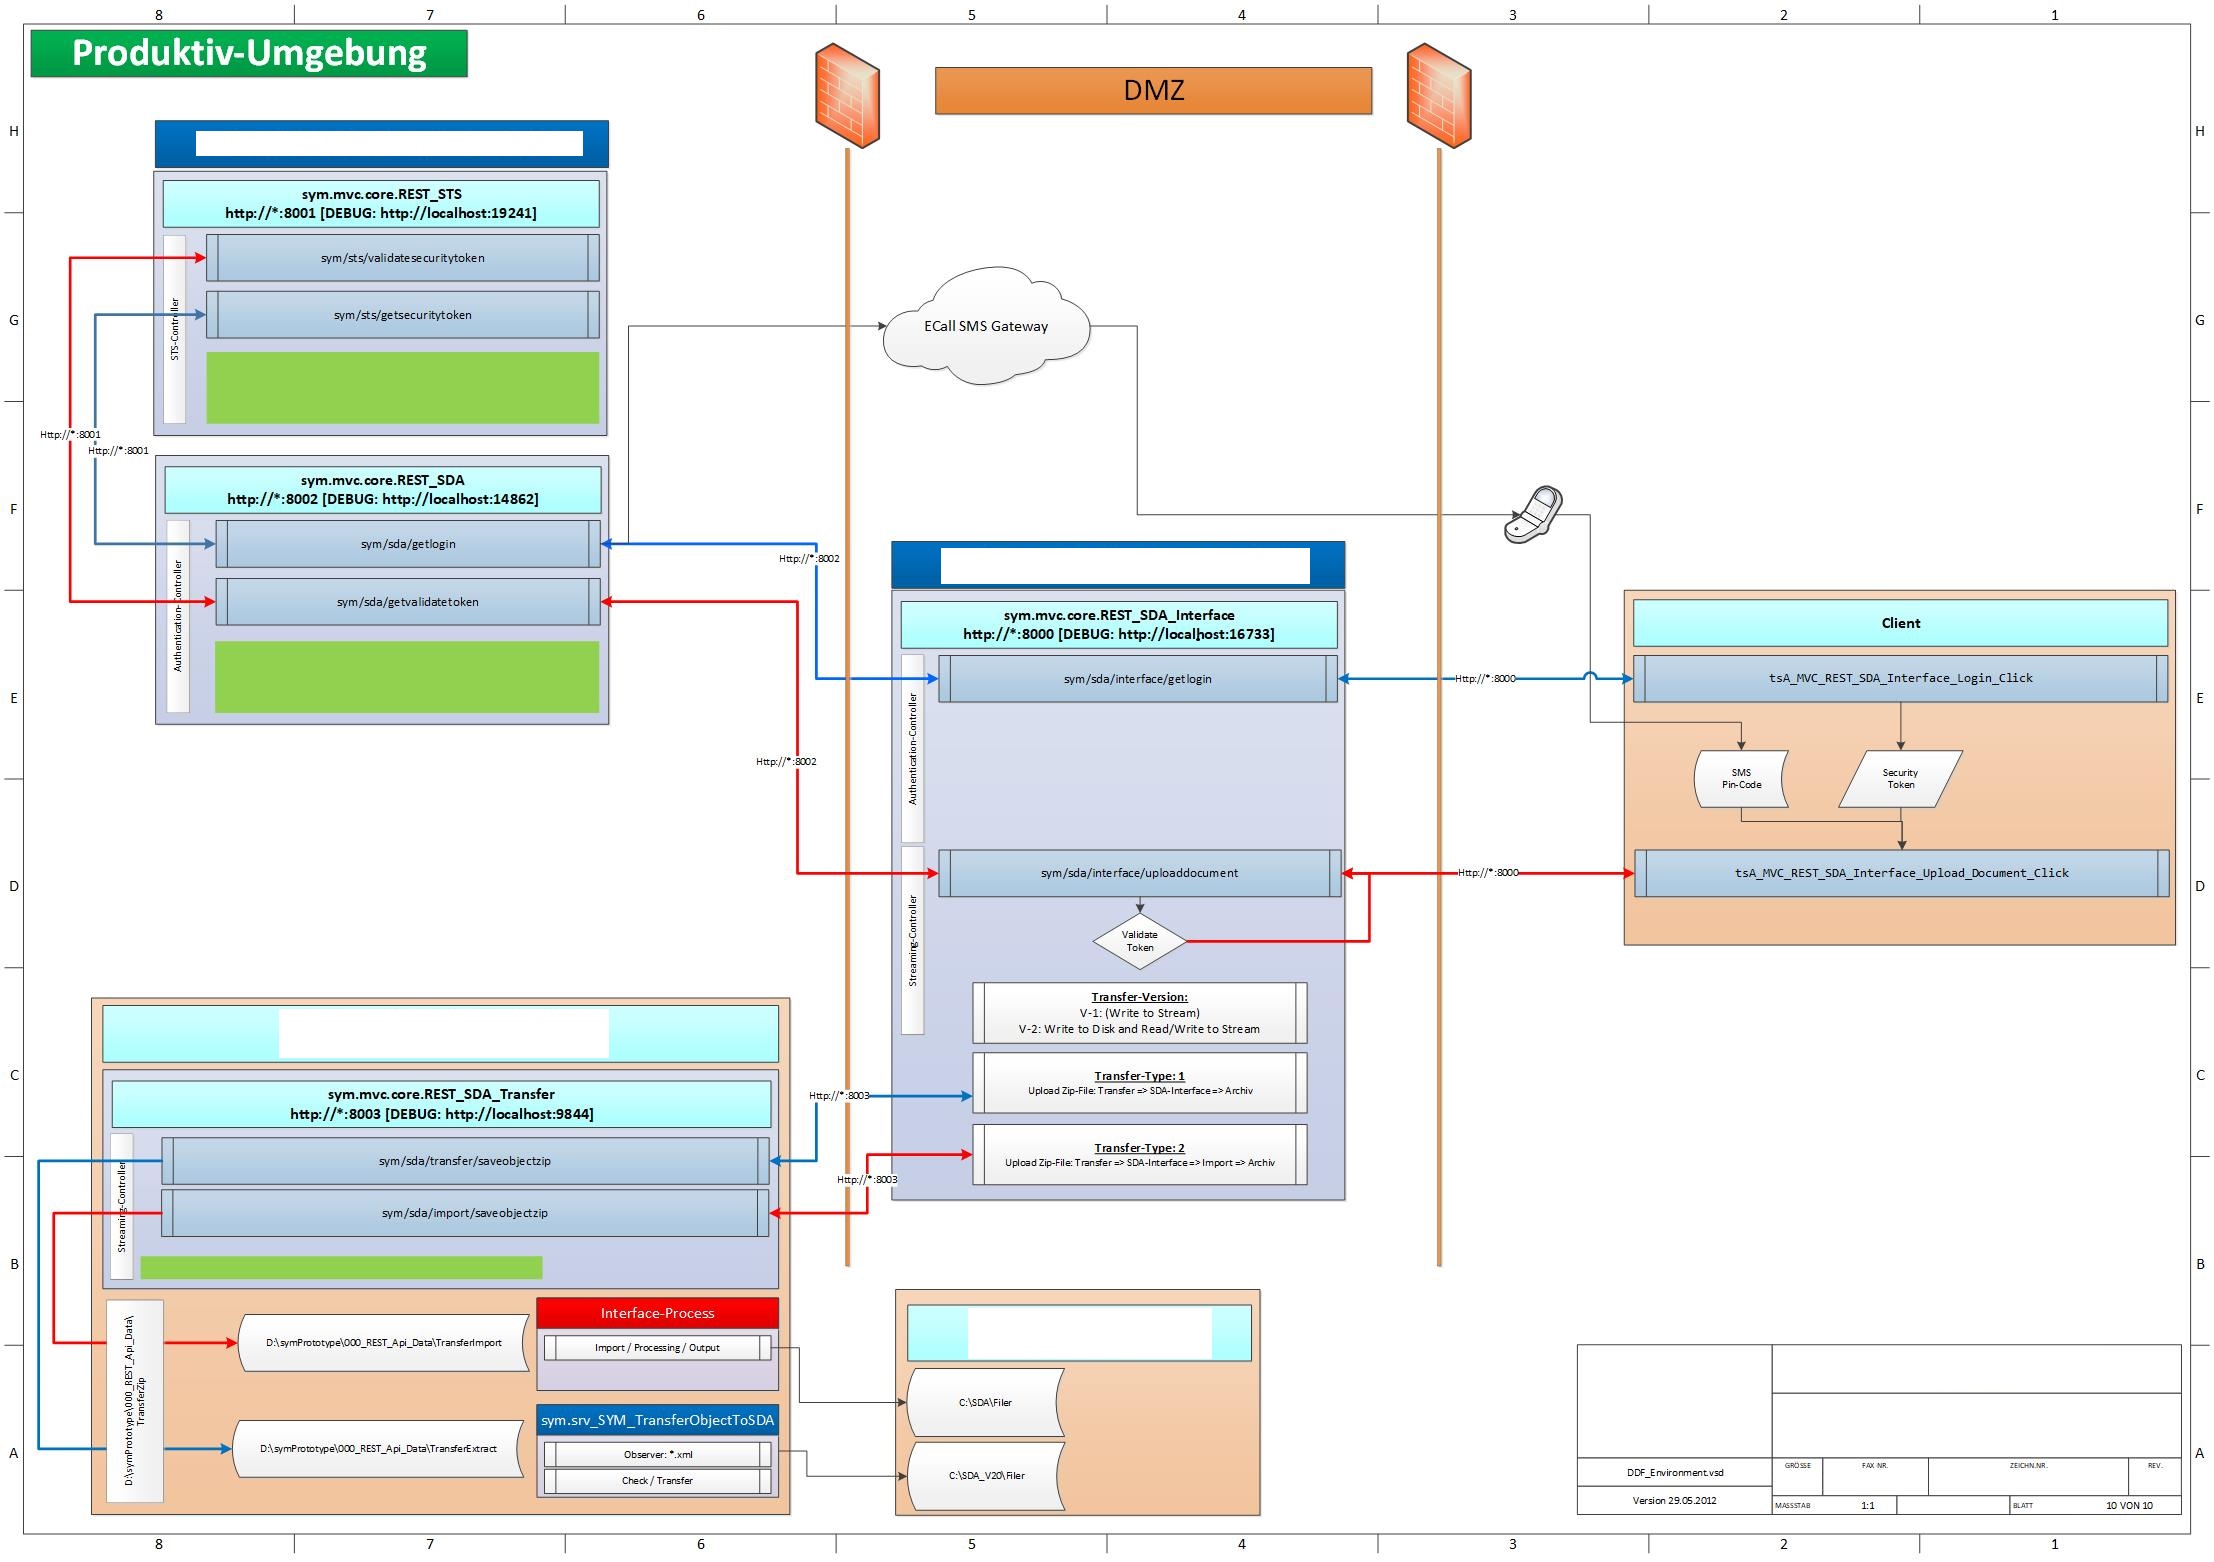
Autorisierung mittels Security-Token-Service
Ein Security Token Service (STS) ist ein Webdienst, der digitale Sicherheitstoken ausstellt, validiert und verwaltet, die zur Authentifizierung und Autorisierung von Benutzern dienen.
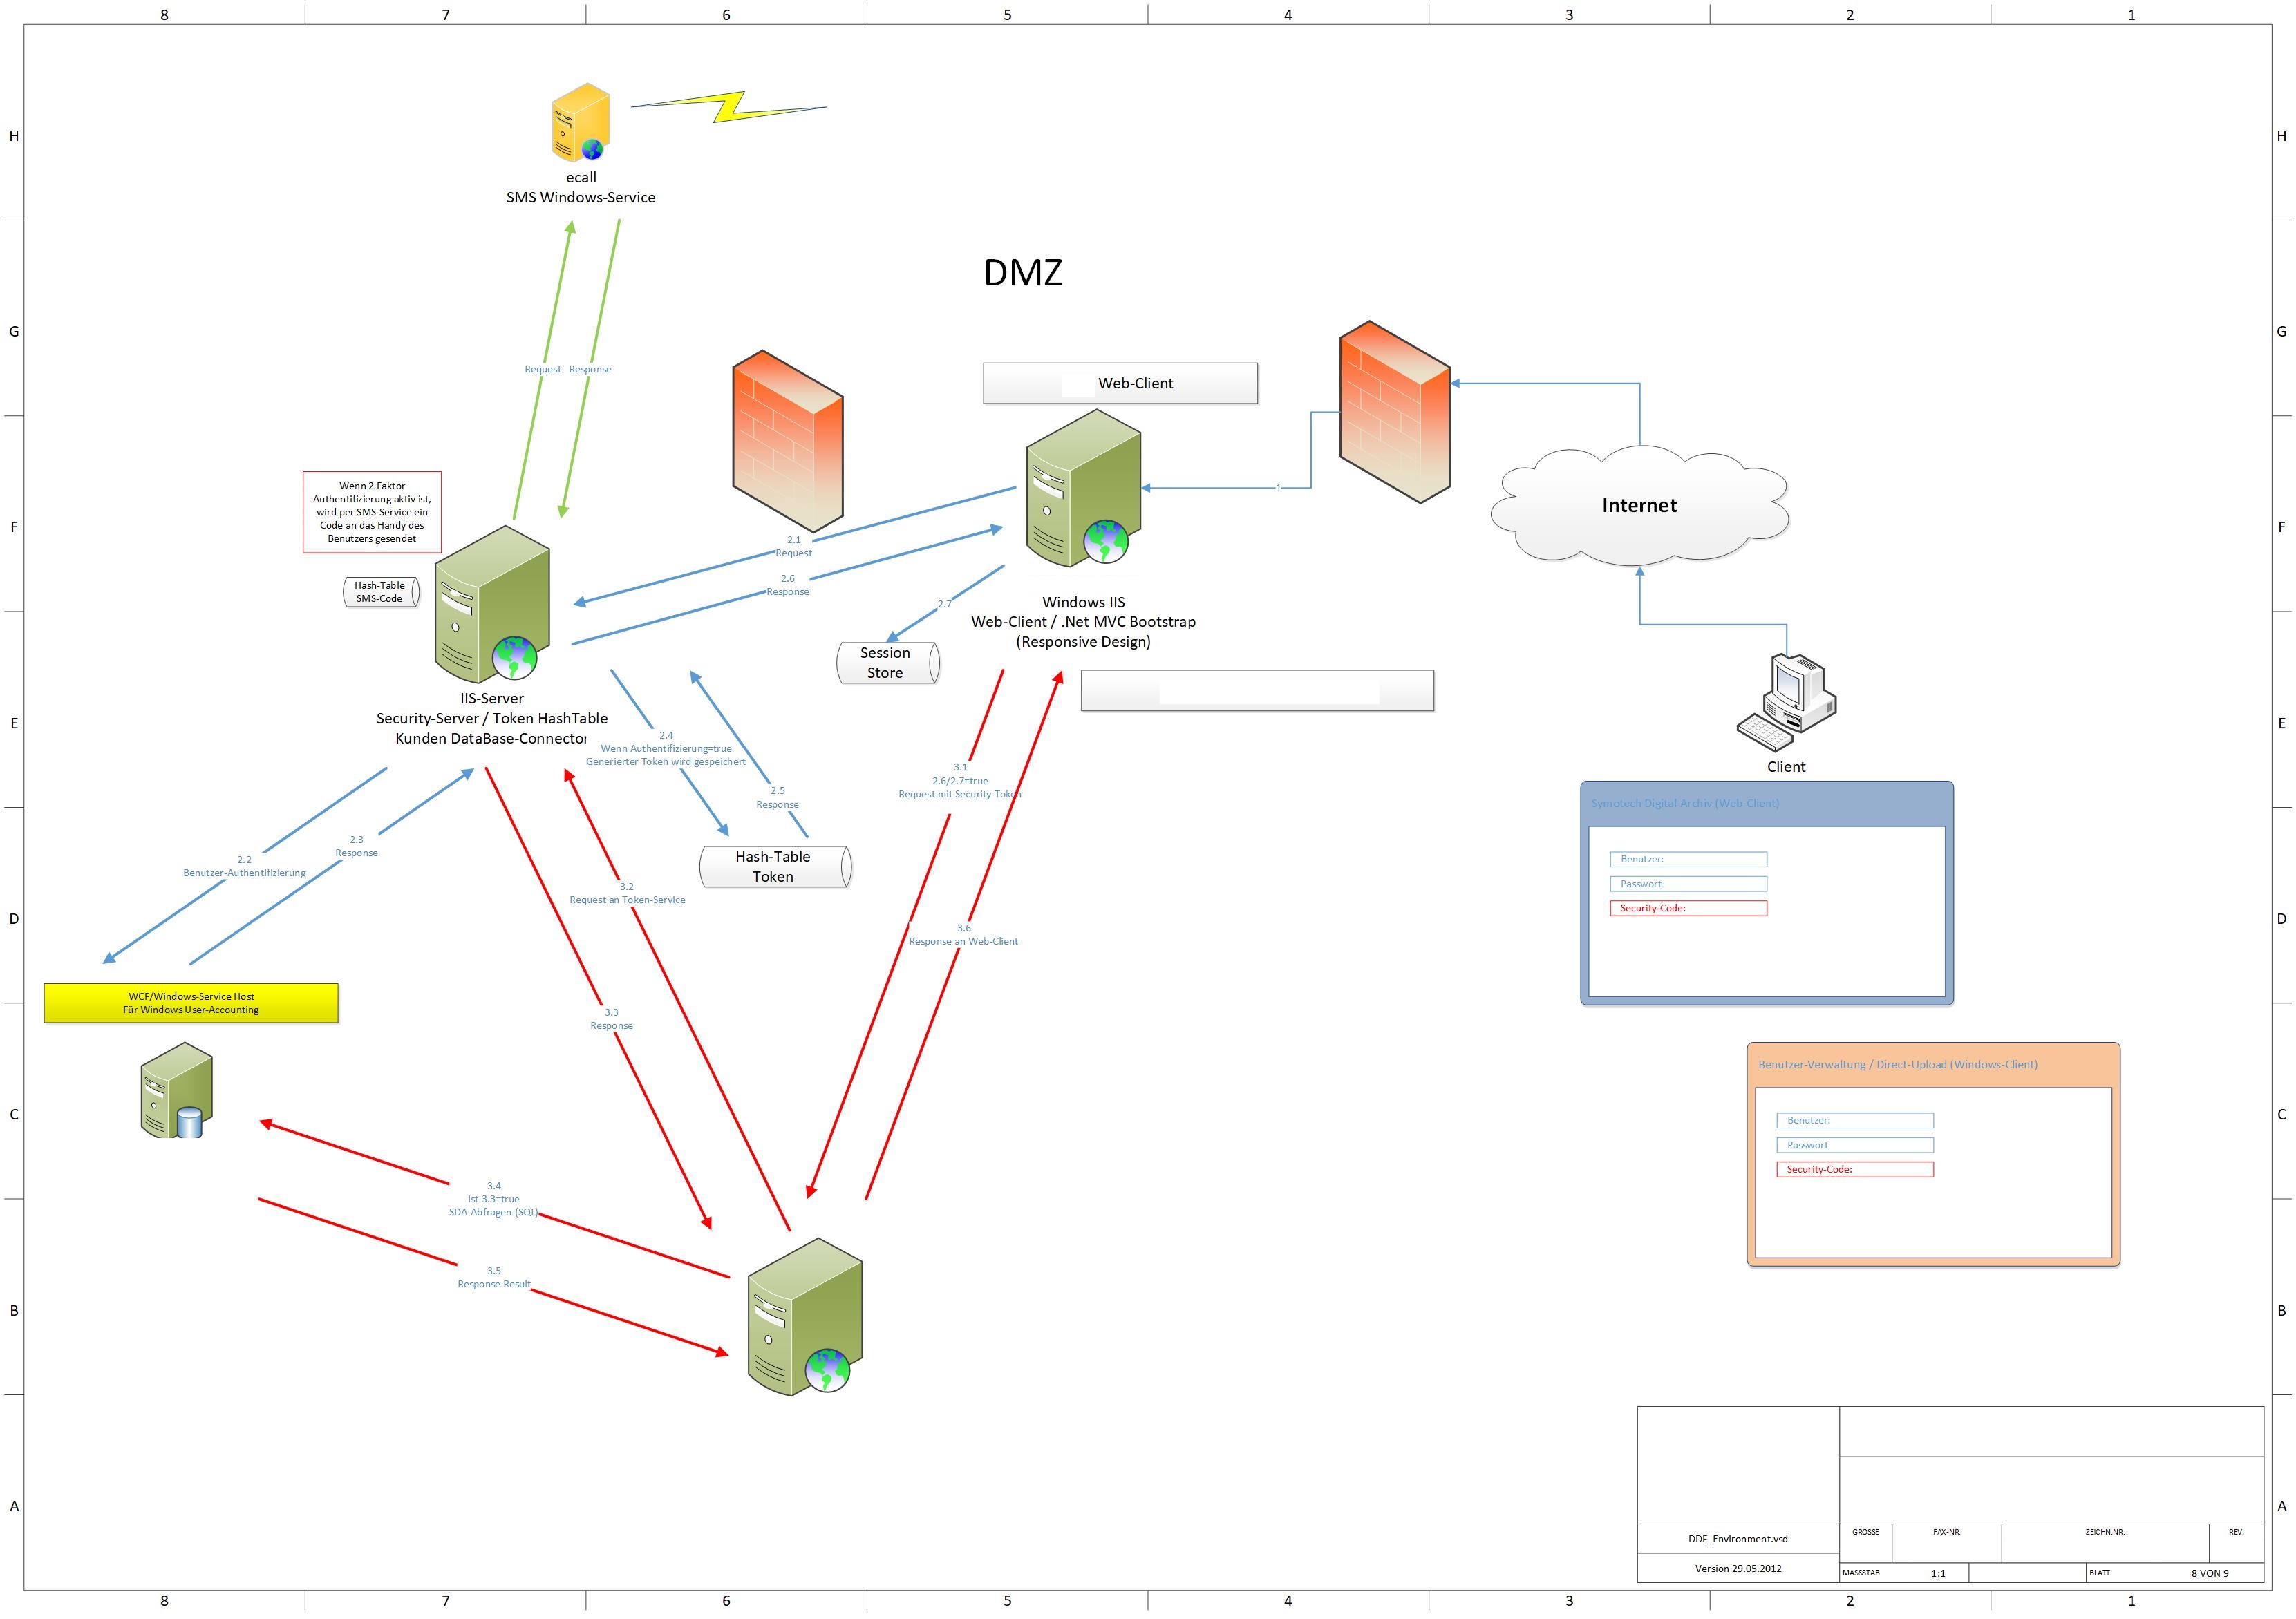
Funktionsweise des STS
- Anforderung: Ein Benutzer oder eine Anwendung übermittelt Anmeldeinformationen an den STS, um die eigene Identität nachzuweisen.
- Ausstellung: Der STS prüft die Anmeldeinformationen und erstellt ein sicheres Token (z. B. ein JWT oder eine SAML-Assertion), das Benutzerdaten oder „Claims“ (Ansprüche/Attribute) enthält.
- Zugriff: Der Benutzer legt dieses Token bei Zielanwendungen oder -ressourcen vor, anstatt ein dauerhaftes Passwort preiszugeben. Validierung: Der empfangende Dienst vertraut dem STS und gewährt Zugriff auf der Grundlage der im Token enthaltenen Berechtigungen.
Datenbank-Archivierung
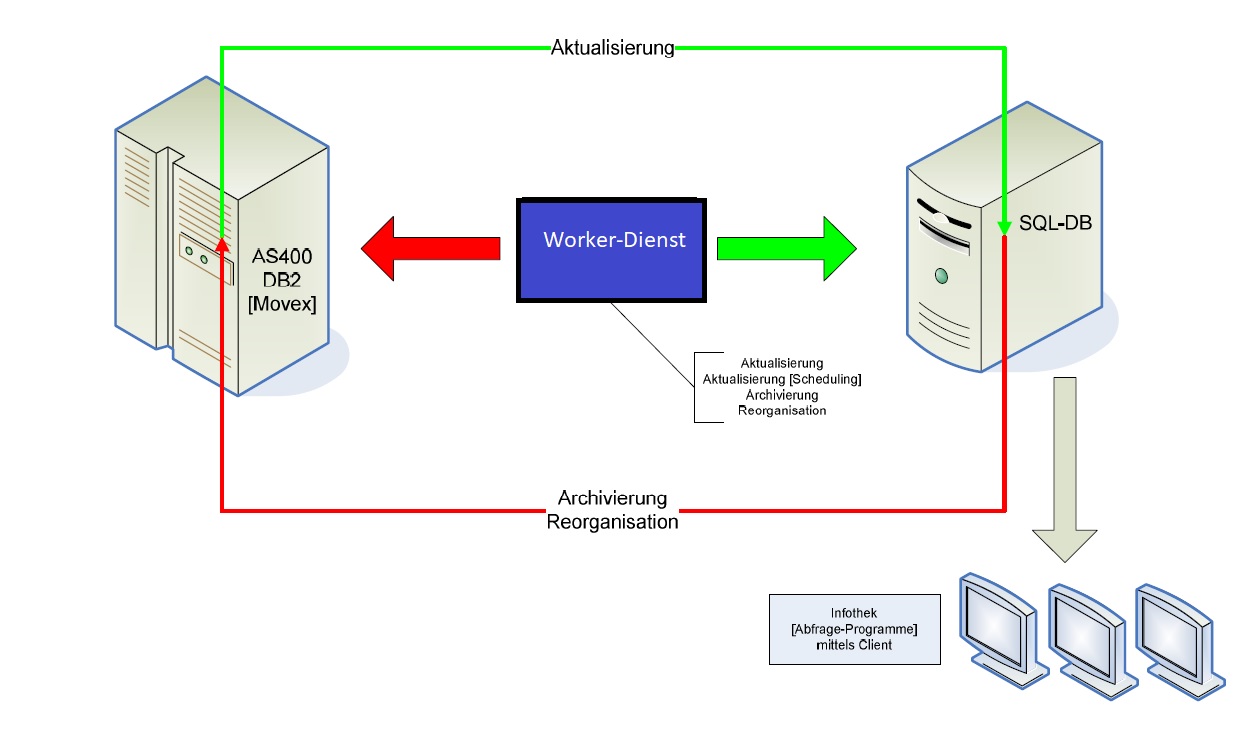
- Durch den Kunden frei einstellbare Archiv-Gruppen, resp. Datenbestände
- Eigenes Job-Scheduling zur Steuerung der festgelegten Exportfunktionen
- Reorganisation auf dem Source-System (DB2) mit einer Notfall Restore-Option für ganze Prozessdaten aus Verkauf / Handel (Auftrag, Positionen, Details, etc).
- Spezielle Hoch performante Datentransfer-Funktionen, Long Running- Applikationen zur Bewältigung der grossen Datenmengen (bis > mehrere hunderte Millionen Datensätze in einer Tabelle).
- Realisierung eines Database-Tools mit Klone-Funktionen für komplette DBInstanzen. Zum Beispiel von iSeries DB2 nach MS-SQL. Auch der Weg aus MSSQL nach iSeries DB2 wurde auf Basis der DDS-Daten (AS/400 Data Description Specifications) Realisiert.
Dialog
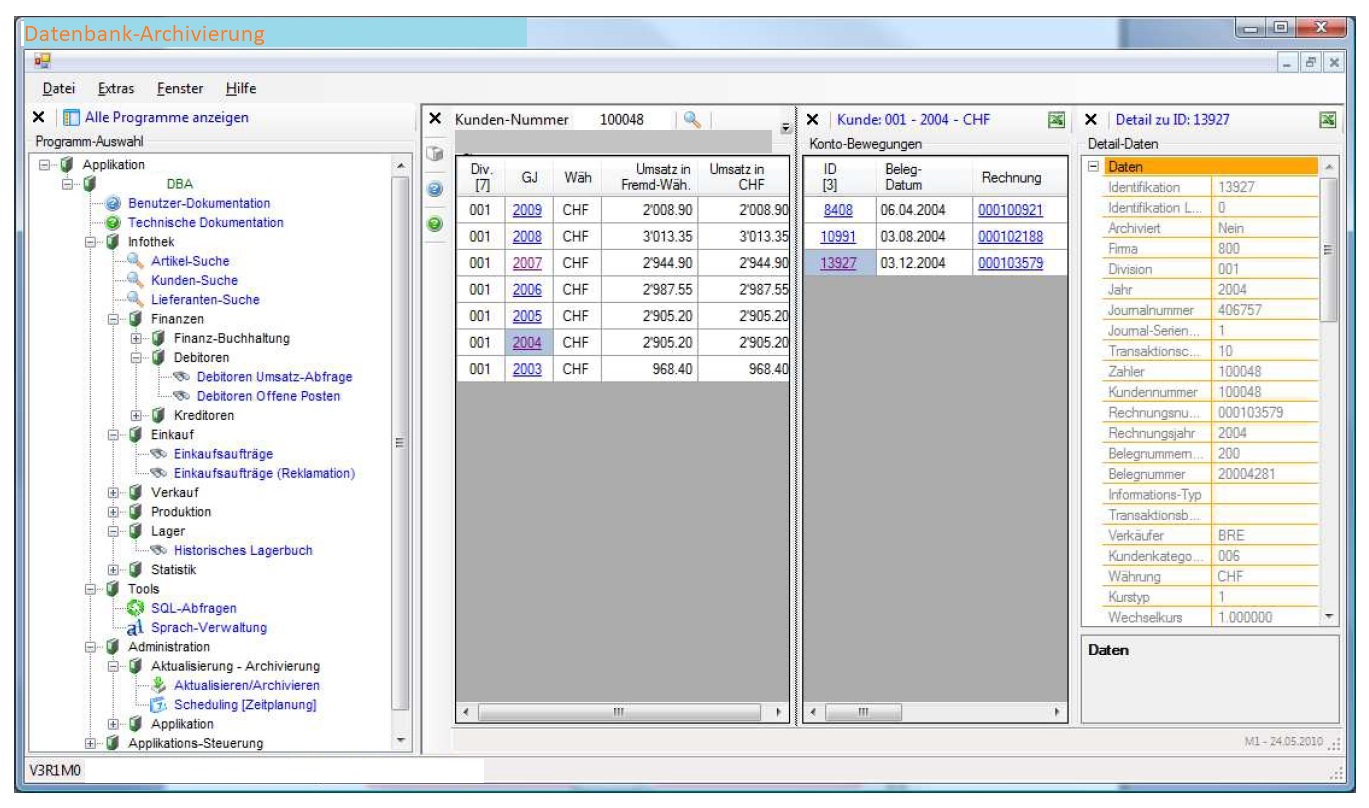
Einstellungen zu den einzelnen Geschäftsbereichen und den Auswertungen können über dieses Dialog erledigt werden.
Backup-Set Definitionen
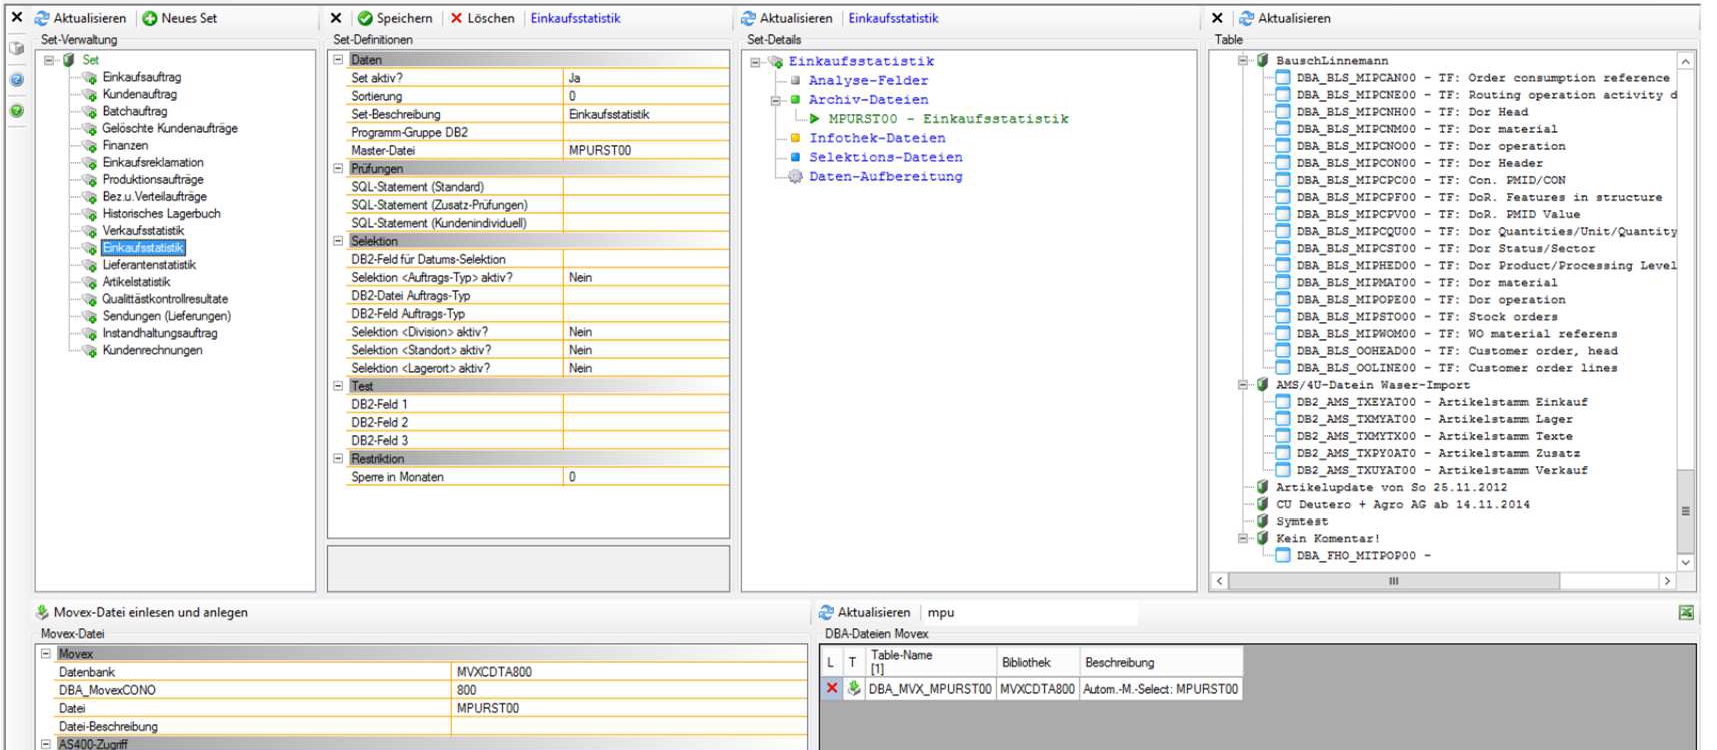
Die detaillierte Definition der einzelnen Data-Set's und deren Inhalt kann in einem solchen Dialog erstellt werden.
Performance
Im Kapitel Data-Base Tool (Clone-Tool) sind sind einige Details zur technologie und der Performance in der Datenbank-Archivierung beschrieben. Auf dieser Grundlage basiert der Datentransfer von einer iSeries DB2 zu einer MS-SQL Datenbank.Content-/Share-Archiv
Absolute Kontrolle über alle Dokumente
Alle Daten / Dokumente welche Sie auf dem Windows
Verzeichnis (Share)
bearbeiten und speichern werden Nachts automatisch in das Cloud Archiv
übernommen. Alle Objekte werden historisiert und sind jederzeit
chronologisch wieder verfügbar.
Funktionen
- Jede Veränderung der Daten auf dem Windows Verzeichnis wird archiviert
- Redundante File Event Engine mit Desaster XML LOG
- Tägliche Verarbeitung der Veränderungen
- Keine Performance Einbussen während der Arbeitszeit
- Durchgehendes Fehlermanagement
- 100% Cloud Lösung mit verschiedenen Storage Optionen
- Mindestvolumen 1 TB
Automatische Überwachung des Fileshare
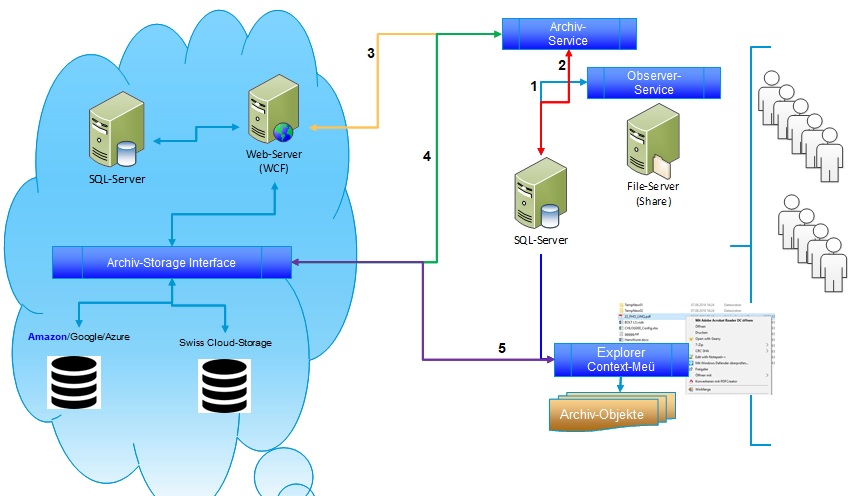
Der Observer Service überwacht und protokolliert alle Veränderungen an den Objekten auf dem definierten Windows Share. Die Konfiguration und Einrichtung ist bewusst sehr einfach gehalten, benötigt keine speziellen Ressourcen. Für die Protokollierung kann eine SQL Express Version (Gratis) verwendet werden.
Periodische Verarbeitung
Jeweils abends oder in einem definierten Intervall verarbeitet der Archive Service alle protokollierten Veränderungen.
Cloudarchivierung
Für jede Veränderung aus dem LOG wird ein neues Share Archiv Objekt in der Levantis Cloud mit allen Objekt Metadaten angelegt. Eine eindeutige Archiv ID wird an den Archiv Service zurückgegeben. Anschliessend wird das Objekt mit der neuen Archiv ID vom lokalen Windows Share in den vom Kunden gewünschten Cloud Speicher übertragen und archiviert.
Objektsuche in der Cloud
Auf dem Client des Anwenders kann über den Explorer und die rechte Maustaste das selektierte oder gesuchte Objekt aus dem Levantis Share Archive abgerufen werden. Gibt es mehrere Versionen werden diese in einer Liste chronologisch dargestellt. Das gewünschte Objekt kann dann mittels diesem Client auf den lokalen Rechner übertragen werden (Download)
Ausgangspunkt dieses Kapitels
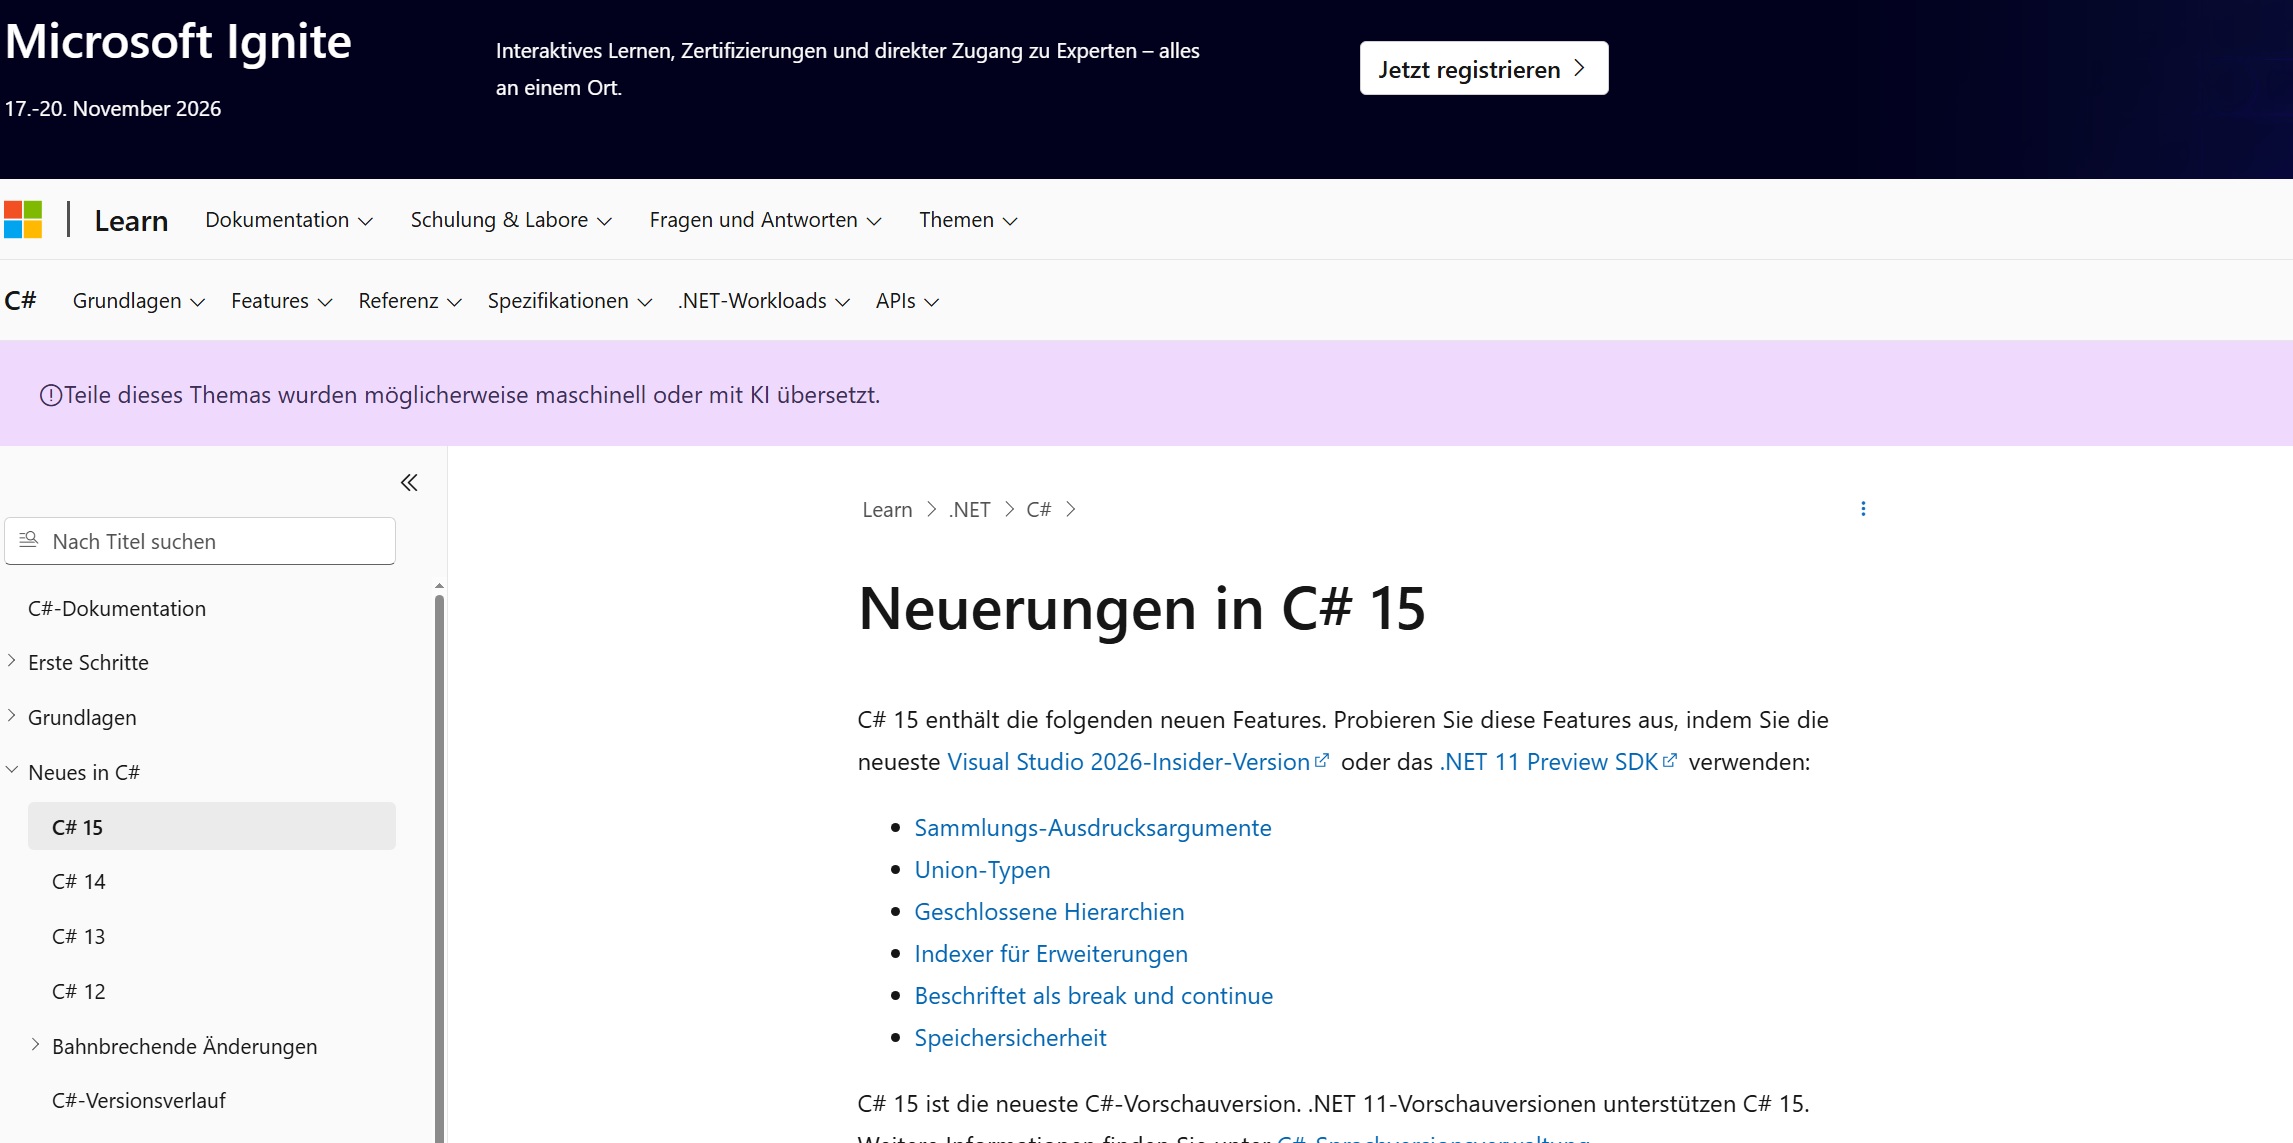
Die von Microsoft permanente Weiterentwicklung und Einführung vieler Neuerungen führt dazu, dass man einfach nicht mehr in der Lage ist, diese vielen permanenten Anpassungen, Erweiterungen und Versionen permanent in seine eigene Software zu implementieren.
Alleine schon die ganzen Umstellungen aus .Net Core und deren Versionen können nicht einfach implementiert, getestet und in eine produktive Umgebung übernommen werden. Vor allem während der Corona-Zeit gab es verschiedene Version und dazu viele Verzögerungen.
Dazu kommt, dass es viele, wirklich viele Optionen und Varianten gibt die man vor einer Umsetzung wirklich genau geprüft haben sollte. Dazu gehören auch Tools, etc. welche bei Microsoft eines Tages dazukommen, und dann auch einfach wieder ausgeschlossen, resp. nicht mehr weiter Entwickelt und gewartet werden.
Was mache ich dagegen!
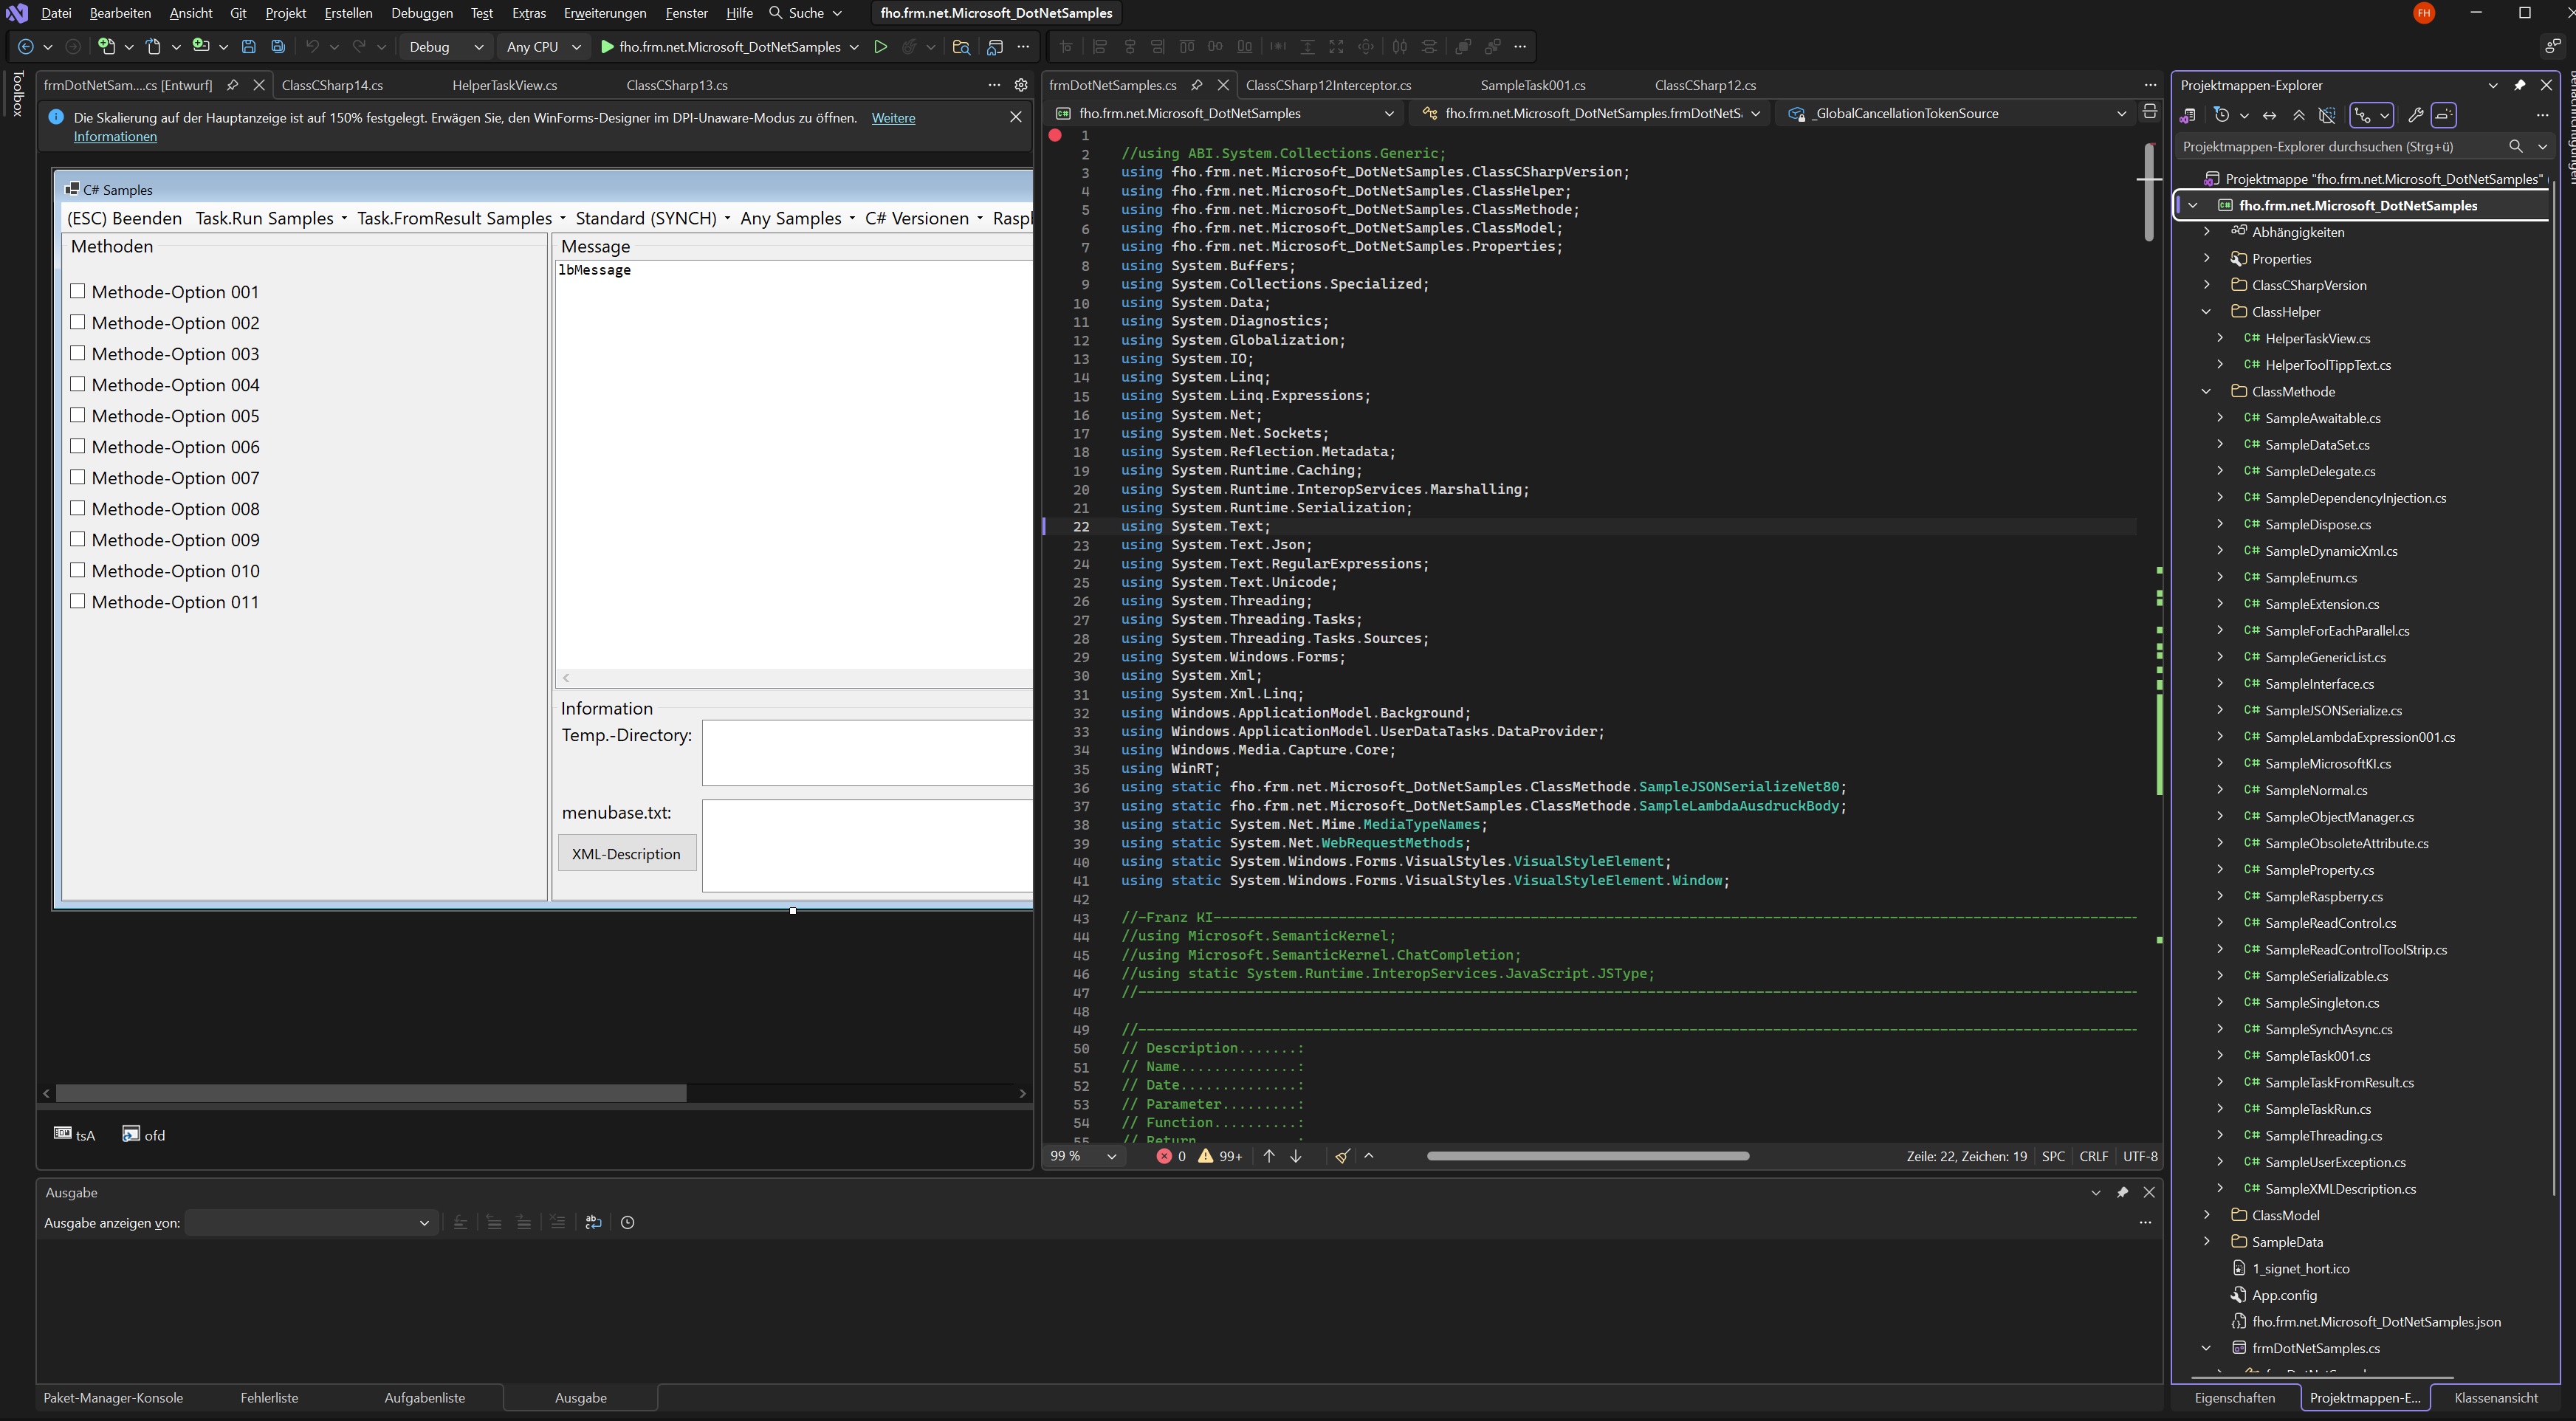
Viele dieser besagten Module, Klassen, Bibliotheken oder SDK's oder wie man diese nennen mag, können in einer vielzahl von verschiedenen sogenannten Design-Pattern realisiert werden. Alleine im Bereich von "async" gibt es viele Varianten, die teilweise markante unterschiede bei den Verarbeitungszeiten aufweisen.
Warum soll ein Prototype erstellt werden?
| Grund | Beschreibung |
|---|---|
| Anforderungen überprüfen: | Man kann feststellen, ob die geplante Software wirklich das Problem der Nutzer löst. |
| Benutzerfreundlichkeit testen: | Nutzer können den Prototyp ausprobieren und Feedback zur Bedienung geben. |
| Fehler früh erkennen: | Statt nur über Funktionen zu sprechen, kann man zeigen, wie die Software später aussehen und funktionieren soll. |
| Kosten und Zeit sparen: | Änderungen am Prototyp sind meist deutlich einfacher und günstiger als Änderungen an fertiger Software. |
| Kunden überzeugen: | Ein Prototyp macht eine Idee greifbar und kann bei Präsentationen oder zur Abstimmung mit Kunden eingesetzt werden. |
| Technische Machbarkeit prüfen: | Man kann testen, ob bestimmte Funktionen technisch realisierbar sind. |
Kurz gesagt: Ein Prototyp dient dazu, eine Software-Idee früh zu überprüfen, Feedback zu bekommen und Risiken zu reduzieren, bevor das eigentliche Produkt entwickelt wird.
Warum Test-Driven Development (TDD)
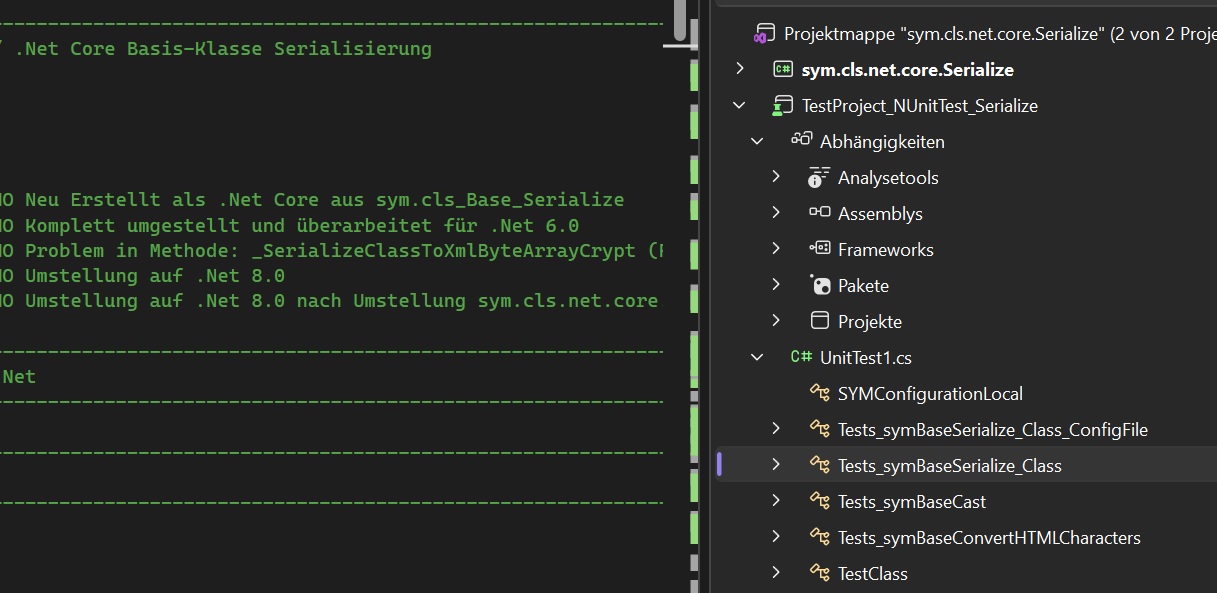
Test-Driven Development bedeutet, dass man zuerst einen automatisierten Test schreibt und danach den eigentlichen Code, der den Test erfüllt.
- 1. 🔴 Red: Einen Test schreiben, der zunächst fehlschlägt.
- 2. 🟢 Green: So wenig Code wie möglich schreiben, damit der Test besteht.
- 3. 🔵 Refactor: Den Code verbessern, ohne die Funktionalität zu verändern.
Die wichtigsten Vorteile
| Vorteil | Beschreibung |
|---|---|
| Weniger Fehler: | Probleme werden früh entdeckt, bevor sie sich durch das System ziehen. |
| Besseres Design: | Weil man den Code zuerst aus Sicht des Benutzers bzw. der Schnittstelle betrachtet, entstehen häufig kleinere und klarer getrennte Komponenten. |
| Sicheres Refactoring: | Man kann bestehenden Code verändern und anschließend die Tests laufen lassen, um sicherzustellen, dass nichts kaputtgegangen ist. |
| Dokumentation: | Gute Tests zeigen, wie eine Funktion verwendet werden soll. |
| Schnelleres Feedback: | Statt eine komplette Anwendung manuell zu testen, kann man viele Tests automatisiert ausführen. |
| Weniger Angst vor Änderungen: | Eine gute Testsuite wirkt wie ein Sicherheitsnetz. |
Kleines Beispiel
Angenommen, Sie möchtest eine Funktion add(a, b) entwickeln.
Beim TDD würden Sie zunächst festlegen:
                            Test:

                            add(2, 3) soll 5 zurückgeben
Der Test schlägt zunächst fehl. Danach implementierem Sie:
add(2, 3) → 5
Anschließend können weitere Fälle hinzufügt werden:
                            add(0, 5) → 5

                            add(-2, 3) → 1

                            add(10, 10) → 20
So entsteht der Code schrittweise aus überprüfbaren Anforderungen.
Aber: TDD ist nicht automatisch besser
TDD hat auch Nachteile. Tests zu schreiben kostet Zeit, und schlecht geschriebene Tests können sogar hinderlich sein.
Außerdem eignet sich TDD nicht für jede Situation gleich gut – beispielsweise bei sehr explorativer Entwicklung oder wenn sich die Anforderungen ständig ändern.
Kurz gesagt: TDD lohnt sich vor allem, wenn Sie zuverlässigen, wartbaren Code entwickeln möchten und häufig Änderungen erwarten.
Es verschiebt einen Teil des Aufwands von späterem Debugging hin zu frühem, strukturiertem Feedback.
Ausgangslage

Eine immer wieder gewünschte Funktion unserer Kunden war die Möglichkeit beim Betrieb eines ERP-Systems,
aktuelle und oder historische Daten aus der Datenbank in eine Testumgebung zu überspielen.
Natürlich gibt es dazu auch Datenbank interne Mechanischem welche die Daten von DB-A nach DB-B synchronisieren.
Der Einsatz solcher Funktionen ist immer mit Definitionsaufwand und Pflege der Installation verbunden.
Hauptproblem bei der ganzen Thematik war und ist, die Performance! Also mit welcher Geschwindigkeit werden Daten von A nach B Transferiert.
Es musste möglich sein, mindestens einen Insert (MS-SQL) von ca. 1000 Records p/Sekunde zu erreichen.
Ausserdem sollte es möglich sein einfache INSERT, UPDATE und DELETE Operationen auf einer Tabelle auszuführen,
damit kleinere manuelle Datenmanipulationen möglich sind, ohne grosse SQL-Scripts und Prozeduren zu Erstellen und Auszuführen.
Ziel
Es sollte also eine Funktion oder besser eine Applikation geschaffen werden,
mit welcher einzelne und/oder alle Tabellen einer Datenbank von einem System zum anderen transferiert werden können.
Auch die Basis der Datenbank-Plattform soll möglichst variabel bleiben, wie AS/400 DB2, MS-SQL, Oracle oder My-SQL.
Die gesamten Operationen im Data-Base Clone-Tool sollen auf den vorhandenen Meta-Daten der Herkunfts,
sowie der Zieldatenbank basieren. Also keine aufwendigen Definitionsarbeiten und keine Programmierkenntnisse sind von Nöten.
Eigentlich muss es möglich sein per Drag & Drop die gewünschten Objekte (Tabellen) von der Herkunft zum Ziel zu Klonen.
Der primäre Fokus muss auf das Thema Performance gelegt werden. Wie können möglichst schnell grosse Datenmenge von A nach B transferiert werden.
Ausgehend von Analysen und Prototypen muss zwingend Parallel-Processing eingesetzt werden,
nur so kann eine Leistungssteigerung erzielt werden welche durch den Einsatz der Hardware beeinflusst werden kann.
Als Zusatz muss es möglich sein einfache manuelle Datenbankoperation per Dialog ausführen zu können.
Realisierung
Hauptdialog der Applikation ist in zwei Hälften aufgeteilt, eine Herkunft und eine Ziel – Instanz.
Natürlich können auch Tabellen von der selben Instanz verglichen werden. Klone-Operation in der gleichen Instanz sind nicht möglich.

Die Hauptaufgabe der Anwendung, das Klonen von Tabellen und Daten steht auf der Stufe Instanz und Tabelle zur Verfügung.
Auf Stufe Instanz können einzelne Tabellen für die verschiedenen Funktionen selektiert werden.
Damit in einer grossen Menge von Tabellen nicht bei jedem Lauf die Selektion neu gemacht werden muss,
können die Einstellungen jeweils gespeichert werden.
Zudem ist das Dialog auch direkt ein LOG-Protokoll welches einzelne Resultate aus der Verarbeitung speichert.
Messungen während der Prototypenphase haben gezeigt, dass es ohne Parallel-Processing nicht gehen kann.
Je nach Ausstattung des Systems (Prozessoren / Kerne) kann die Transferleistung stark vergrössert werden.
Für das Kopieren der Daten vom Herkunft zum Zielsystem stehen 4 Varianten zur Verfügung:
| Methode | Beschreibung |
|---|---|
| Copy Data (Standard / Sequentiell) | Es werden alle selektierten Tabellen nacheinander Verarbeitet. |
| Copy Data V.-1.0 (Parallel) | Die Logik für DataReader (FROM) und der BulkInsert (TO) ist getrennt. Der Data-Reader wird direkt im Parallel-Process Start ausgeführt, und als Referenz an den BulkInsert-Process übergeben. MS-SQL Schema-Struktur ist verfügbar. (Implementierung in DataBaseParallel-Klasse) |
| Copy Data V.-2.0 (Parallel) | Der DataReader (FROM) und der BulkInsert (TO) in einer Methode implementiert, welche durch den Parallel-Process (TASK) gestartet wird. Pro Task sind also alle Operation gekapselt und Threadsicher implementiert. MS-SQL Schema-Struktur ist verfügbar. (Implementierung in DataBaseParallel-Klasse) |
| Copy Data V.-3.0 (Parallel) | Der DataReader (FROM) und der BulkInsert (TO) in einer Methode implementiert, welche durch den Parallel-Process (TASK) gestartet wird. Pro Task sind also alle Operation gekapselt und Threadsicher implementiert. MS-SQL Schema-Struktur ist verfügbar. Absoluter Vorteil dieser Methode ist, dass sogar einzelne Tabellen durch mehrere WHERE-Bedingungen auf einzelne Task aufgeteilt werden. Dadurch werden auch grosse Datenmengen in einzelnen Tabellen auf mehrere Task aufgeteilt. (IDataBase-Interface / DataBase-Klasse) |
Bei einer Menge n Tabellen mit wenig Datensätzen und einer oder mehreren Tabellen mit grossen Mengen an Datensätzen
ist der Parallel-Prozess pro Tabelle nicht wirklich schnell,
daher wurde in der V.-3.0 Version die Möglichkeit implementiert dass pro Tabelle mehrere WHERE-Klauseln definiert
werden können die dann ebenfalls in einem eigenen Task ausgeführt werden.

Das Beispiel zeigt die Detail WHERE-Schlaufen für die Tabelle EB1600. Ist keine solche Definition vorhanden, wird die Tabelle als Ganzes an einen Task übergeben.

Das Dialog-Bild welches die Optionen und Varianten bei der Klone-Operation zeigen.
Schnellster je gemessener Datentransfer von AS/400 DB2 nach Microsoft SQL brachte eine INSERT-Rate auf dem SQL-Server von ca. 7800 Datensätzen pro Sekunde. Hardware-Basis 1 Prozessor mit 4 Kernen und 16 GB Memory.